CUPED e variantes: testes A/B na metade do tempo
CUPED, CUPAC, MLRATE. O pacote de variance reduction que tá rodando em toda plataforma moderna de A/B
Como Microsoft, DoorDash e Meta cortaram pela metade o tempo de teste A/B usando dados que já tinham, e por que a métrica importa mais que a técnica
No artigo anterior eu mencionei CUPED de passagem como “uma técnica que reduz sample size sem mudar a metodologia”. Saiu proporcionalmente curto pro tamanho do que essa coisa faz.
CUPED (Controlled-experiment Using Pre-Experiment Data) foi publicado em 2013 por Deng, Xu, Kohavi e Walker, da Microsoft. O paper original mostra que, usando comportamento pré-experimento como covariável, conseguiram reduzir a variância das métricas do Bing em cerca de 50%. Variância 50% menor significa metade do tamanho de amostra pra detectar o mesmo efeito, ou seja, metade do tempo. Pra uma empresa que roda milhares de testes A/B por ano, isso é dobrar a velocidade de iteração sem mexer em nada visível do produto.
Hoje CUPED tá implementado nas plataformas internas de Microsoft, Netflix, Booking, Airbnb, Meta, Uber, DoorDash, Etsy, Faire, TripAdvisor, e em todas as principais plataformas comerciais, Statsig, Eppo, VWO, Kameleoon, Amplitude. Se você roda A/B em algo moderno, provavelmente CUPED já tá rodando por baixo sem você ver.
A estrutura desse artigo é assim, primeiro CUPED clássico (intuição, matemática, por que funciona), depois as duas extensões modernas, CUPAC do DoorDash (2020) e MLRATE da Meta (2021). Em seguida cubro onde a coisa pode quebrar, e termino com um guia amplo de como pensar sobre adotar isso no seu programa de experimentação.
A intuição, heavy users já eram heavy antes do teste
Pensa numa plataforma qualquer com a métrica “sessões por usuário em 14 dias”. O power do seu teste é a função da variância dessa métrica, e a variância é alta porque os usuários são muito heterogêneos. Tem usuário que abre o app 80 vezes por semana, tem usuário que abre 2 vezes por mês. Quando você compara controle e tratamento, boa parte do ruído é simplesmente essa diferença entre tipos de usuário caindo aleatoriamente em cada grupo.
A randomização cuida disso na média, mas amostralmente sempre vai sobrar diferença, e essa diferença residual é o que infla seu intervalo de confiança e pede mais N.
A observação que muda a forma de abordar, o usuário heavy de hoje é o usuário heavy de 30 dias atrás. Se eu sei que o usuário X fez 80 sessões nos 30 dias antes do experimento, eu posso prever, sem nenhum modelo sofisticado, que ele vai fazer mais sessões que a média durante o experimento. Não estou prevendo o efeito do tratamento, estou prevendo a baseline dele.
A ideia do CUPED é simples, em vez de comparar Y_tratamento com Y_controle, eu comparo Y_tratamento - predição_baseline com Y_controle - predição_baseline. A heterogeneidade do baseline some, a única coisa que sobra é o efeito do tratamento (que é o que eu queria desde o começo) mais um ruído residual menor.
Não está inventando informação, só removendo um pedaço da variância que já sabia existir e que não tem nada a ver com o que esta sendo testado.
A matemática
O ajuste do CUPED é uma linha:
Y_cuped = Y - theta * (X - mean(X))onde:
- Y é a métrica durante o experimento (ex: sessões em 14 dias)
- X é a métrica pré-experimento (ex: sessões nos 30 dias anteriores)
- theta = cov(Y, X) / var(X) é o coeficiente que minimiza a variância residual
Isso é uma regressão linear de Y em X. O theta é a inclinação da reta que melhor prevê Y a partir de X.
A variância de Y_cuped é, no limite:
var(Y_cuped) ≈ var(Y) * (1 - rho²)onde rho é a correlação entre Y e X. Quanto maior a correlação entre o comportamento pré e durante, maior a redução. Nada além disso.
Em resumo, fica uma tabela:
 rho  |  redução var  |  sample size equivalente
------+---------------+-------------------
 0.3  |       9%      |  91% do N original
 0.5  |      25%      |  75% do N original
 0.7  |      49%      |  51% do N original
 0.8  |      64%      |  36% do N original
 0.9  |      81%      |  19% do N original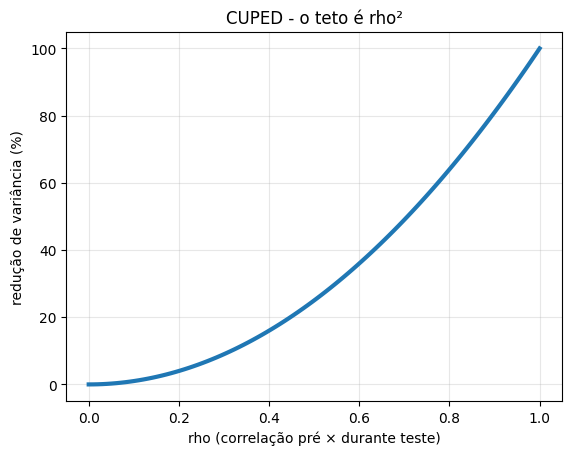
Redução de variância como função do rho. CUPED entrega exatamente rho² da variância original, nem mais, nem menos. Microsoft viu ~50% no Bing porque rho lá fica entre 0.7 e 0.8.
A Microsoft cita rho típicos entre 0.6 e 0.8 nas métricas do Bing, o que dá redução de variância de 36% a 64%, em linha com os 50% que reportaram. A diferença entre uma plataforma que adota CUPED e ganha 50% e uma que adota e ganha 5% é o rho, e o rho é função da métrica, não da técnica.
Por que isso não introduz viés
A pergunta natural é, “se eu mexer no Y, não vou enviesar o teste?”.
Não, e a razão é estrutural. X é pré-experimento, foi observado antes do tratamento ser aplicado. Por construção, X é independente de T (o indicador de tratamento). Como theta * (X - mean(X)) tem média zero e independe de T, subtrair isso de Y não muda a diferença entre os grupos.
Em fórmula:
E[Y_cuped | T=1] - E[Y_cuped | T=0] = E[Y | T=1] - E[Y | T=0]A média da diferença é igual. O que muda é a variância, o ruído entre indivíduos cai, então o erro padrão da diferença cai junto, então o p-value cai (quando há efeito) e o intervalo de confiança fica mais estreito.
Tendo um detalhe, o theta tem que ser estimado no pool inteiro (controle + tratamento), não separado por grupo. Estimar por grupo introduz viés porque o theta passa a capturar parte do efeito do tratamento.
Vale destacar essa propriedade. Várias “otimizações” em A/B parecem aumentar power mas na verdade só estão inflando falso positivo (peeking, p-hacking, segmentação ad-hoc, mencionadas no artigo anterior). CUPED é matematicamente sem viés, ele estreita o intervalo de confiança sem mexer no centro.
CUPAC, a extensão do DoorDash (2020), ML como covariável
CUPED clássico usa uma covariável (X) por vez. Mas em produção, você quase sempre tem várias features pré-experimento, recência, gasto histórico, número de sessões, categoria preferida, dispositivo, localidade, canal de aquisição. Combinar tudo manualmente é trabalhoso e nem sempre ótimo.
Em 2020, Jeff Li, Yixin Tang e Jared Bauman do DoorDash publicaram um blog post descrevendo o CUPAC, Control Using Predictions As Covariate. A ideia é uma generalização limpa:
- Treina um modelo de ML (GBM, random forest, rede neural) pra prever Y a partir de todas as features pré-experimento disponíveis.
- Usa a predição do modelo como o “X” do CUPED.
Por que isso é melhor que CUPED clássico? Porque um modelo de ML captura relações não-lineares e interações entre features que uma única covariável não captura. Se “usuário novo + alto gasto pré + categoria X” prevê melhor o comportamento durante que cada uma delas isoladas, o modelo aprende isso, e a redução de variância aumenta.
O CUPAC moderno é o cross-fitting, padrão hoje no DoorDash (Dash-AB, 2022) e no Etsy (2025). A ideia é treinar o modelo em K folds (geralmente 5), gerando predições out-of-sample pra cada usuário. Isso evita dois problemas:
- Vazamento, se você treinar no pool inteiro, o modelo aprende ruído individual e parte do efeito do tratamento.
- Pequeno demais se você treinar só no grupo de controle, perde metade do sample size, e o modelo prevê fora da distribuição no tratamento.
Cross-fitting resolve os dois, todo usuário é predito por um modelo treinado em outros usuários. Sem isso, CUPAC pode até piorar a variância em vez de melhorar.
No DoorDash, em sistemas de logística com switchback testing, CUPAC entregou cerca de 10% a mais de redução de variância que CUPED simples. O Etsy reportou em 2025 que migrar de CUPED para CUPAC encurtou a duração média dos experimentos em aproximadamente 3 dias.
Quando CUPAC vale a pena sobre CUPED? Quando você tem várias features pré-experimento com sinal complementar. Quando você tem uma única feature dominante (tipo “sessões pré” que já explica quase tudo), o ganho marginal é pequeno.
MLRATE, a evolução de Meta (NeurIPS 2021)
Yongyi Guo e colegas, em paper de 2021 publicado no NeurIPS, propuseram o MLRATE (Machine Learning Regression-Adjusted Treatment Effect stimator). É parecido com CUPAC mas com a diferença que em vez de subtrair a predição do Y, ele inclui a predição como regressor numa regressão maior, com termo de interação:
Y = beta0 + tau*T + beta1*g(X) + beta2*(T * g(X)) + epsonde g(X) é a predição de ML cross-fitted (igual ao CUPAC), e tau é o estimador do ATE.
A vantagem de MLRATE sobre CUPAC é uma propriedade que importa em produção, ele é consistente mesmo se o modelo de ML for mal ajustado. CUPAC depende do modelo capturar bem a relação X→Y, se o modelo erra, CUPAC pode piorar a variância. MLRATE é mais robusto porque:
- A randomização garante balanceamento de T entre grupos.
- O termo de interação T*g(X) absorve parte do erro do modelo.
- A inferência via OLS clássico dá erros padrão na média honestos.
Em troca, MLRATE é levemente mais complexo (uma regressão com interação em vez de subtração simples), e ligeiramente menos eficiente que CUPAC quando o modelo está bem especificado. É a aposta defensiva, troca um pouco de eficiência por robustez.
Meta usa MLRATE em produção em vários produtos do Facebook e Instagram. Pra time que já tem cultura de ML e quer estabilidade em produção, é a escolha mais segura.
Resumindo os três
CUPED
Subtrai theta * (X - mean(X)) de Y, com X sendo uma única métrica pré-experimento. Use quando você tem uma covariável dominante ou tá começando. Baixo risco, é provado como sem viés.
CUPAC
Treina um modelo de ML cross-fitted pra prever Y a partir de várias features pré-experimento, e usa a predição como X. Use quando você tem várias features com sinal complementar. Risco real, pode piorar variância se o modelo for ruim.
MLRATE
Mesma ideia do CUPAC mas via regressão com termo de interação T*g(X). Use quando quer robustez ao treino do modelo. Mais complexo, marginalmente menos eficiente quando ML é bom.
Os três compartilham a mesma premissa central, comportamento pré-experimento prevê comportamento durante. Quando essa premissa vale, qualquer um dos três entrega valor (CUPED 80% do caminho, CUPAC e MLRATE os 20% restantes). Quando a premissa não vale, nenhum dos três entrega.
Onde as coisas dão aquela complicada
1. Métrica esporádica, rho baixo
Primeiro problema é estrutural, não tem solução técnica. Se sua métrica é esporádica, comportamento bursty (comportamento que ocorre do nada em volume grande), eventos raros, atividade descontínua, o rho entre pré e durante vai ser perto de zero. E redução = rho² significa que CUPED entrega 1% se rho for 0.1.
Métricas habituais (rho alto, CUPED rende bem):
- Queries por usuário em busca (Bing, Google), rho típico 0.6–0.8
- Sessões diárias em rede social, rho típico 0.6–0.7
- Gastos recorrentes em e-commerce com base frequente, rho típico 0.5–0.7
- Volume de mensagens em aplicação de chat, rho típico 0.6–0.8
- Logins por semana em SaaS, rho típico 0.6–0.7
Métricas esporádicas (rho baixo, CUPED não salva):
- Avaliações de filme/série, rho típico 0.05–0.15
- Primeira compra em e-commerce, rho próximo de zero (não tem pré)
- Compras de bens duráveis (carro, imóvel), rho próximo de zero
- Conversão em produto premium com taxa <1%, rho baixo por raridade
- Reviews espontâneos, rho 0.1–0.2
Por que essa diferença? Comportamento habitual carrega de um período pra outro. Quem pesquisa muito em maio pesquisa muito em junho, porque pesquisar virou hábito. Comportamento esporádico não carrega, quem avaliou muitos filmes em maio (assistiu uma série de filmes no feriado por ex) pode não avaliar nenhum em junho (sem catálogo legal, sem tempo, sem interesse).
A Microsoft viu 50% no Bing porque escolheu uma métrica certa pra técnica. Se sua métrica chave é esporádica, CUPED não é o seu problema mais urgente, é a métrica.
2. Outliers, mesmo com rho cooperando
Independente da técnica e do dataset, se sua distribuição tem caudas pesadas (baleias, fraudes, eventos isolados), CUPED não resolve sozinho. Um único usuário com Y elevado em 100x ou 1000x pode:
- Saturar theta em valores extremos (perto de 1.0 ou de zero)
- Distorcer a média da diferença entre grupos
- Inflar o intervalo de confiança a ponto de inutilizar o teste
Um dos casos clássicos cobri no artigo anterior, bibliotecas comprando livros em lote na Amazon, inflando o ticket médio. Microsoft, Booking, todas empresas grandes aplicam winsorização (clip no percentil 99) antes de qualquer análise.
A regra prática é, winsorização vem antes do CUPED, sempre. Sem isso, mesmo CUPED clássico em métrica habitual pode quebrar com 0.01% de usuários extremos no dataset.
3. Novos usuários sem histórico
Se um usuário se cadastrou ontem e seu experimento começou hoje, ele tem zero dias de pré-experimento. X = 0 ou X = NaN. Três abordagens, em ordem de qualidade:
- Imputar zero e deixar CUPED rodar. Funciona mas dilui o ganho, porque pra esses usuários o ajuste é nulo.
- Separar análise em dois segmentos (novos vs recorrentes) e aplicar CUPED só nos recorrentes. Reporta os dois separadamente.
- Usar features alternativas (canal de aquisição, geo, device, demografia) como proxies via CUPAC. Funciona quando você tem dados de cadastro ricos.
Quando o produto cresce em alta velocidade (startup early-stage, expansão geográfica, viralização), fração de novos usuários pode ser grande (50%+), e CUPED clássico perde poder. Aí CUPAC com features de cadastro vira o caminho.
4. Não-estacionariedade entre pré e durante
Se o pré-experimento foi dezembro (black friday) e o experimento é janeiro (ressaca), a relação X→Y muda. Quem comprou muito em dezembro não necessariamente compra em janeiro, porque o contexto é diferente. O theta estimado em dezembro não é válido em janeiro.
Isso aparece em qualquer produto com sazonalidade forte, e-commerce (datas comerciais), turismo (alta/baixa temporada), educação (calendário acadêmico), fitness (janeiro × março), entrega de comida (jogos de futebol, eleições), ações da bolsa (eventos políticos).
Regras práticas:
- Iguale a janela ao período do experimento. Se o experimento dura 14 dias, use 14 a 28 dias antes, não 90.
- Evite cruzar mudanças sazonais conhecidas. Não use dezembro como pré pra janeiro.
- Reestimar theta periodicamente se você está aplicando CUPED de forma contínua.
- Validar em cenários de testes qual janela maximiza rho na sua métrica.
Booking e outras plataformas com sazonalidade forte às vezes recomendam outras técnicas (horizonte fixo, sequential testing) em vez de CUPED nesses cenários.
5. Métricas razão (CTR, conversion rate por sessão)
CUPED clássico assume métricas média (média de Y por usuário, ex: spending per user). Métricas razão (clicks/impressions, transactions/visits, conversions/sessions) têm covariância adicional entre numerador e denominador que CUPED simples não trata corretamente.
O resultado é que CUPED pode ficar tecnicamente correto mas subutilizado nessas métricas, ou pior, dar estimativas incorretas. Existem variantes específicas, CUPED para métricas razão, que aparecem no paper de Deng et al. 2023 e em implementações de Statsig, Eppo, Microsoft.
Se sua métrica chave é razão (e em A/B na web, conversão e CTR são razão), vale usar a variante correta. Senão você está usando a ferramenta certa no problema errado.
6. Trigger asymmetry
Em feature flags onde a feature só renderiza no grupo de tratamento (ex: “novo botão aparece só pra quem está em tratamento”), o evento de exposição só dispara em T=1. Os “triggered” no controle tecnicamente não existem, e isso quebra a comparação simétrica que CUPED assume.
Alex Deng publicou paper específico sobre isso em 2021, “Variance Reduction for Experiments with One-Sided Triggering using CUPED”. A ideia é usar dados pré-experimento pra estimar quem teria sido triggered no controle se a feature existisse, e aplicar CUPED só nesse subconjunto.
Esse é um pitfall específico de A/B na web/mobile com features condicionalmente renderizadas. Se você roda testes só com features que aparecem nos dois grupos (mudou texto de botão, mudou ranking de busca), você não tem esse problema.
Como pensar sobre implementar
Guia amplo, em ordem de prioridade. A ideia é organizar as decisões antes de ir pro técnico.
1. Antes de qualquer outra coisa, meça rho. Pega 30 dias de dados históricos como X, os próximos 14 dias como Y, na sua métrica chave, e tira a correlação. Faz isso pra cada métrica que você considera importante. Algumas vão dar 0.7 (boa notícia), outras 0.1 (sinal pra reconsiderar essa métrica como OEC).
Se rho > 0.5 na sua métrica chave, segue. Se rho < 0.3, três caminhos:
- Aplica mesmo assim, ganha pouco mas não perde nada
- Considera trocar a métrica chave (surrogate metric mais densa)
- Aceita que essa métrica vai exigir N grande sempre
2. Garanta os fundamentos antes de mexer em redução de variancia. Variance reduction sem essas bases é decorar a fachada de uma casa sem fundação. Cobri todos no artigo anterior, mas em resumo:
- SRM (Sample Ratio Mismatch) monitorado
- OEC (Overall Evaluation Criterion) declarada antes de cada teste
- Guardrails (métricas que não podem regredir)
- A/A periódico pra validar hash de bucketing
- Multiple testing controlado (Bonferroni, FDR, ou sequential adequado)
Sem isso, CUPED só vai dar resultado bonito em cima de inferência ruim.
3. Sempre winsorize antes. Percentil 99 no Y como mínimo, percentil 95 se sua métrica é particularmente pesada de cauda. Isso vale com ou sem CUPED, sempre. Custa zero de implementação.
4. Comece com CUPED clássico. É 7 linhas de código, baixo risco. A covariável é a mesma métrica que você está medindo, mas no período pré-experimento. Não tente sofisticar antes de ver isso funcionando. CUPED simples captura 80% do ganho potencial.
Pontos operacionais:
- Estimar theta no pool, não por grupo
- Reestimar a cada experimento, não guardar um theta universal
- Persistir o theta junto com o resultado pra auditoria futura
- Reportar redução de variância explícita no resultado de cada teste, times aprendem a esperar ganhos quando rho é alto
5. Suba pra CUPAC quando o ganho marginal justificar. Os critérios pra subir:
- Você tem várias features pré-experimento com sinal complementar (não só a métrica em si)
- O time tem maturidade em ML (saber treinar GBM, validar, manter e cuidar de concep drift)
- Você já está vendo o teto do CUPED clássico (testou, ganhou 20%, quer mais)
Cuidado com vazamento, use cross-fitting com K=5 folds, sempre. Treinar no pool inteiro sem split parece simples mas vaza o efeito do tratamento. Treinar só no controle perde sample size de treino. Cross-fit resolve os dois.
6. Considere MLRATE se ML é instável em produção. Se você tem volatilidade no comportamento do modelo (drift entre treinos, diferenças entre abordagens e resultados entre cientistas, mudanças de feature), MLRATE é mais defensivo. A robustez compensa a complexidade extra.
7. Variantes especializadas quando o caso pede. Métrica razão use a variante. One-sided trigger use o paper do Deng 2021. Métrica de cauda pesada considere CUPED em log(Y) em vez de Y direto.
8. A/A periódico depois de implementar. Roda A/A com CUPED, com winsorização, com tudo, e confirma que a taxa de falso positivo é ~5%. Se ficar 7%, você tem viés escondido. Se ficar 3%, você tá sendo conservador demais. CUPED é matematicamente sem viés, mas a sua implementação pode não ser.
9. Decida o ciclo de manutenção. Quem cuida da curadoria de features pra CUPAC? Quando reestimar theta? Como auditar resultados antigos se mudar a metodologia? Plataformas comerciais escondem isso, plataformas caseiras têm que decidir. Sem ciclo, a coisa vai pro caralho em 6 meses.
Quem usa o quê
Microsoft (Bing), paper original em 2013, CUPED em todos os experimentos automaticamente, redução típica 30–50% nas métricas-chave.
Netflix, paper de Xie e Aurisset em 2016, CUPED com redução de variancia estratificada por região e device, adaptado pro contexto de streaming e métricas de longo prazo.
DoorDash, CUPAC publicado em 2020. Roda em todos os experimentos do sistema de dispatch. Redução adicional de ~10% sobre CUPED simples. Dash-AB (plataforma deles) reporta 10–20% de redução de sample size com CUPED + CUPAC empilhados.
Etsy, publicou em 2021 sobre CUPED, em 2025 sobre CUPAC. CUPED simples deu 7% médio (com cauda longa, alguns experimentos até 30%) e CUPAC encurtou ~3 dias adicionais na duração média.
Meta, MLRATE publicado em 2021, padrão interno em produtos com cultura de ML.
Booking, redução de variância combinada com sequential testing, 25.000 testes por ano com plataforma que aplica CUPED automaticamente.
Statsig, Eppo, VWO, Kameleoon, Amplitude, todas implementam CUPED por baixo nos resultados topo de linha. Statsig é particularmente explícita sobre isso na documentação deles.
A lição prática, se você está rodando A/B em SQL caseiro, implementar CUPED com sete linhas de Python te coloca no nível dos gigantes em sensibilidade, se sua métrica cooperar.
O ROI hoje depende muito mais da estrutura da sua métrica do que da elegância do código.
Conclusão
CUPED, CUPAC e MLRATE compõem hoje o pacote silencioso de redução de variância que tá rodando por baixo de praticamente toda plataforma moderna de A/B. As três compartilham a mesma premissa, comportamento pré-experimento prevê comportamento durante, e divergem na sofisticação com que tentam capturar essa relação:
- CUPED (2013), uma covariável, álgebra linear, 80% do ganho potencial com 20% do esforço.
- CUPAC (2020), ML cross-fitted multivariado, captura não-linearidades, 10% a mais de ganho quando há sinal nas features.
- MLRATE (2021), regressão com interação, robusta a erro do modelo, mais defensiva em produção.
O denominador comum é o rho, a correlação entre pré e durante. rho é o seu teto, e ele depende da métrica, não da técnica. Microsoft viu 50% de redução no Bing porque queries por usuário são habituais (rho 0.6-0.8). Se sua métrica é esporádica (avaliações, primeiras compras, eventos raros), nem CUPED, nem CUPAC, nem MLRATE vão te salvar. A escolha da métrica importa mais que a técnica que você aplica em cima dela.
Recomendações da minha cabeça:
- Meça rho na sua métrica chave em dados históricos. Hoje, antes de ler o resto.
- Se rho > 0.5, implementa CUPED clássico (sete linhas, gratuito, comprovado).
- Sobe pra CUPAC com cross-fit quando o ganho marginal das features extras justificar a complexidade.
- MLRATE quando você quer dormir tranquilo com o modelo de ML em produção.
- Winsoriza no P99 sempre, com ou sem CUPED.
E o que não funciona é pular o passo 1. Pular o “meça rho” é a forma mais comum de implementar CUPED achando que vai ter o ganho da Microsoft e ficar com 2%. Sete linhas de pandas resolvem essa medição.
CUPED não é mágica, é álgebra. E álgebra honesta sempre te entrega exatamente o que você colocou. Se a sua métrica não traz rho, a álgebra não inventa.
Referências
- Deng, A., Xu, Y., Kohavi, R., Walker, T. (2013). “Improving the Sensitivity of Online Controlled Experiments by Utilizing Pre-Experiment Data”. WSDM 2013. PDF
- Xie, H., Aurisset, J. (2016). “Improving the Sensitivity of Online Controlled Experiments: Case Studies at Netflix”. KDD 2016.
- Li, J., Tang, Y., Bauman, J. (2020). “Improving Experimental Power through Control Using Predictions as Covariate (CUPAC)”. DoorDash Engineering Blog.
- Guo, Y. et al. (2021). “Machine Learning for Variance Reduction in Online Experiments (MLRATE)”. NeurIPS 2021. arXiv:2106.07263
- Deng, A., Yuan, L.-H., Salama-Manteau, A. (2021). “Variance Reduction for Experiments with One-Sided Triggering using CUPED”. arXiv:2112.13299
- Deng, A. et al. (2023). “From Augmentation to Decomposition: A New Look at CUPED in 2023”. arXiv:2312.02935
- Lin, Z., Crespo, P. (2024). “Variance reduction combining pre-experiment and in-experiment data”. Etsy/Berkeley. arXiv:2410.09027
- Kohavi, R., Tang, D., Xu, Y. (2020). Trustworthy Online Controlled Experiments: A Practical Guide to A/B Testing. Cambridge University Press.
- Statsig Documentation. “Variance Reduction”.
- Etsy Code as Craft. “Reducing experiment duration with predicted control variates”.