Índices no MySQL: O trade-off que ninguém te conta
Você já teve uma query que demorava 30 segundos e, depois de criar um índice, passou a rodar em 50ms? Essa sensação é boa demais. Mas e quando você percebe que seu sistema de inserção em massa que era rápido começou a travar após adicionar “só mais um índice”?
Esse é o trade-off que quase ninguém fala. Este artigo explica como índices funcionam por dentro, o que você ganha, o que você paga, e apresenta um benchmark que eu fiz para medir esse custo na prática.
Afinal, o que é um índice?
Pensa num livro sem índice ordenado. Para encontrar todas as páginas que mencionam “B-Tree”, você teria que ler o livro inteiro, do começo ao fim. Isso é o que o banco faz quando você não tem índice, um full table scan, leitura linha por linha até achar o que procura.
Um índice é uma estrutura de dados separada, mantida pelo banco em paralelo à tabela, que permite localizar registros sem varrer a tabela toda. O InnoDB (engine padrão do MySQL) usa uma estrutura chamada B-Tree (Balanced Tree).
B-Tree: a estrutura por trás de tudo
Uma B-Tree organiza os dados em nós hierárquicos ordenados. A busca começa pela raiz, desce pelos nós intermediários comparando valores, até chegar nas folhas, onde ficam os ponteiros para os dados reais. Em vez de ler todas as N linhas, você percorre apenas log(N) nós. Para uma tabela com 1 milhão de linhas, a diferença entre varrer tudo e navegar pela árvore pode ser de centenas de milissegundos com microssegundos.
         [50]
        /    \
    [25]      [75]
   /    \    /    \
 [10] [30] [60] [90]
A B-Tree mantém os valores sempre ordenados. Isso é fundamental para entender tanto os ganhos quanto os custos.
O que você ganha com índices
Buscas muito mais rápidas
O caso de uso mais óbvio. Com um índice em email, uma query como WHERE email = ‘franco@mail.com’ não precisa mais ler todas as linhas da tabela. O banco navega pela B-Tree e chega direto.
O mesmo vale para ordenação (ORDER BY) e junções (JOIN), se as colunas envolvidas estão indexadas, o banco não precisa ordenar tudo na memória.
Índices compostos: ordem importa
Um índice em (col_a, col_b) beneficia queries que filtram por col_a sozinha, ou por col_a e col_b juntos , mas não beneficia uma query que filtra só por col_b. Isso porque a árvore está ordenada primeiro por col_a, depois por col_b dentro de cada valor de col_a.
É a chamada regra do “leftmost prefix”, o índice composto funciona se você usar as colunas da esquerda para a direita.
O que você paga com índices
Aqui está a parte que costuma ser ignorada.
Cada INSERT tem um custo extra
Quando você insere uma linha na tabela, o banco não apenas escreve o dado. Ele precisa atualizar cada índice existente, encontrar a posição correta na B-Tree, inserir o novo valor e, se necessário, rebalancear a árvore para mantê-la equilibrada. Esse processo é chamado de page split quando um nó fica cheio.
Se você tem 9 índices numa tabela, cada INSERT faz, na prática, 10 escritas (uma na tabela + nove nas estruturas de índice). O custo cresce linearmente com o número de índices.
Espaço em disco
Cada índice é armazenado em disco. Em tabelas com muitas colunas indexadas ou com dados pesados (como UUIDs em CHAR(36)), o espaço dos índices pode facilmente superar o espaço dos dados em si.
UUID vs INT: por que o tipo de dado importa tanto
UUID é uma ótima escolha para muitos sistemas, ele garante unicidade global sem coordenação central, facilita merges entre bancos distribuídos, e evita a exposição de IDs sequenciais previsíveis em APIs públicas. Para aplicações modernas, especialmente as distribuídas, faz muito sentido.
O ponto é, usar UUID com qualidade exige consciência do custo. UUIDs são gerados de forma aleatória, então quando você os usa como valor indexado, cada inserção precisa encontrar uma posição aleatória na B-Tree, o que causa muito mais page splits do que um INT AUTO_INCREMENT, que sempre vai para o final da árvore (é sequencial por natureza).
Se você quer o melhor dos dois mundos, existe o UUID v7 (ordenado por timestamp) e estratégias como o UUID_TO_BIN(uuid, 1) do MySQL, que reordena os bytes para reduzir esse problema.
O benchmark, medindo o custo na prática
Para visualizar esse trade-off, criei um benchmark que testa diferentes cenários de indexação com inserções concorrentes no MySQL. O código está disponível no GitHub: francocontigo/index-insert-mysql-benchmark.
Metodologia
O script (benchmark_indexes.py) testa 4 cenários de índices:
- baseline: sem nenhum índice secundário
- few: 2 índices simples (col_a, col_b)
- medium: 4 índices simples + 1 composto
- many: 6 índices simples + 3 compostos (9 índices no total)
Para cada cenário, o benchmark roda com dois tipos de dado nas colunas, INT e UUID (CHAR(36)), e dois volumes: 50.000 e 200.000 linhas, usando 4 threads paralelas de inserção. Cada cenário é executado 5 vezes e a média é calculada.
# Exemplo de cenário "many" — 9 índices secundários
"many": [
    "CREATE INDEX idx_a ON test_indexes(col_a)",
    "CREATE INDEX idx_b ON test_indexes(col_b)",
    "CREATE INDEX idx_c ON test_indexes(col_c)",
    "CREATE INDEX idx_d ON test_indexes(col_d)",
    "CREATE INDEX idx_e ON test_indexes(col_e)",
    "CREATE INDEX idx_f ON test_indexes(col_f)",
    "CREATE INDEX idx_ab ON test_indexes(col_a, col_b)",
    "CREATE INDEX idx_cd ON test_indexes(col_c, col_d)",
    "CREATE INDEX idx_ef ON test_indexes(col_e, col_f)"
]
O que o benchmark revela
Os gráficos abaixo foram gerados diretamente do notebook de análise (analysis_indexes.ipynb) após as execuções.
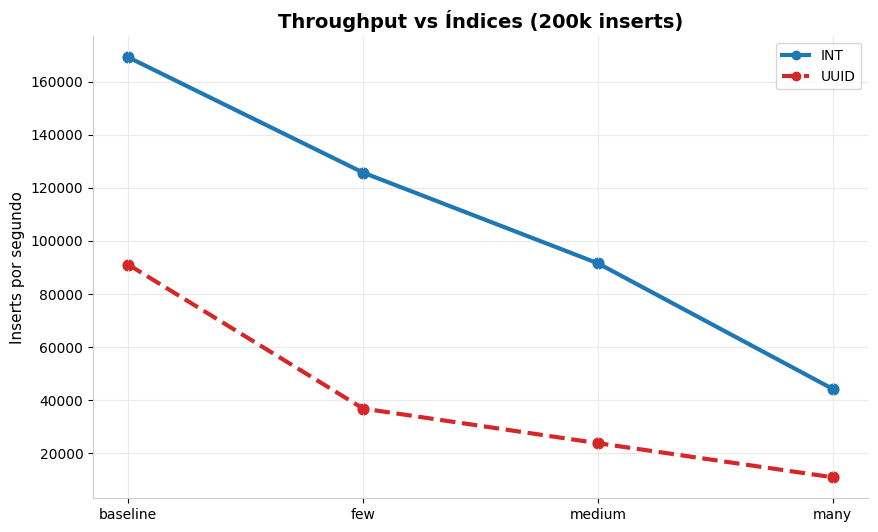
Throughput vs Índices (200k inserts) , linha azul INT, linha vermelha pontilhada UUID:
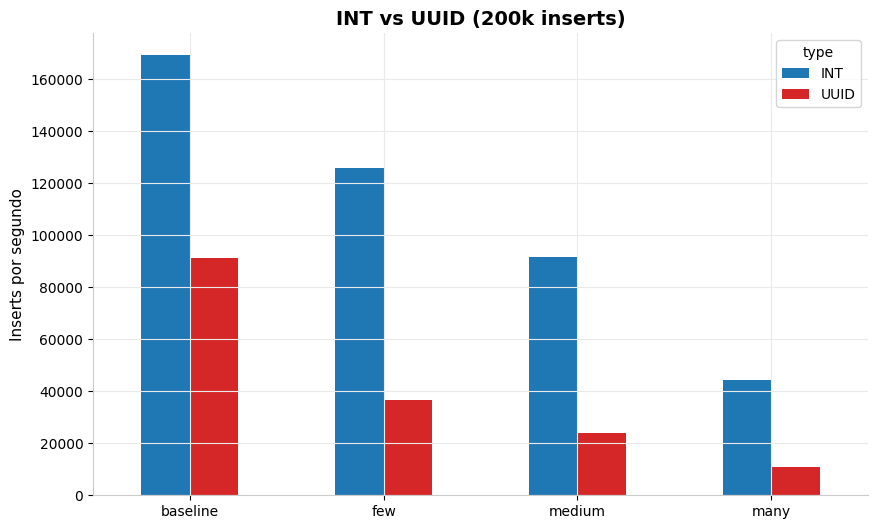
INT vs UUID lado a lado:
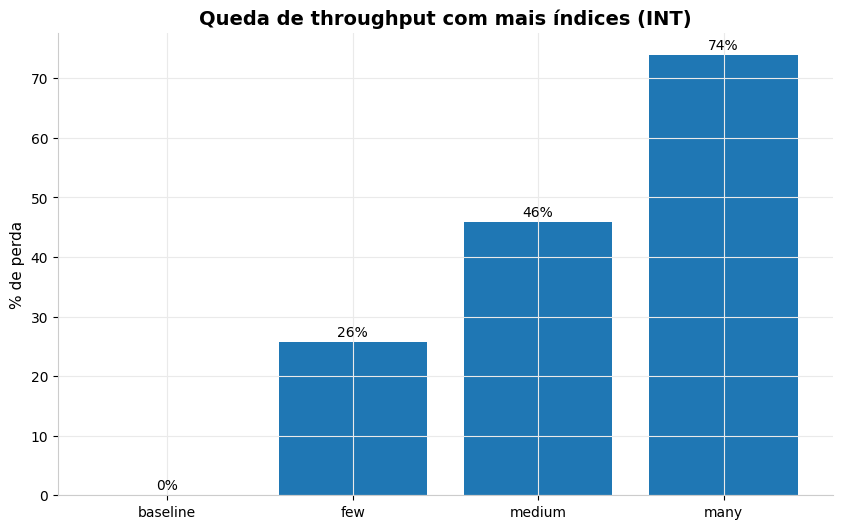
Queda de throughput com mais índices, INT:
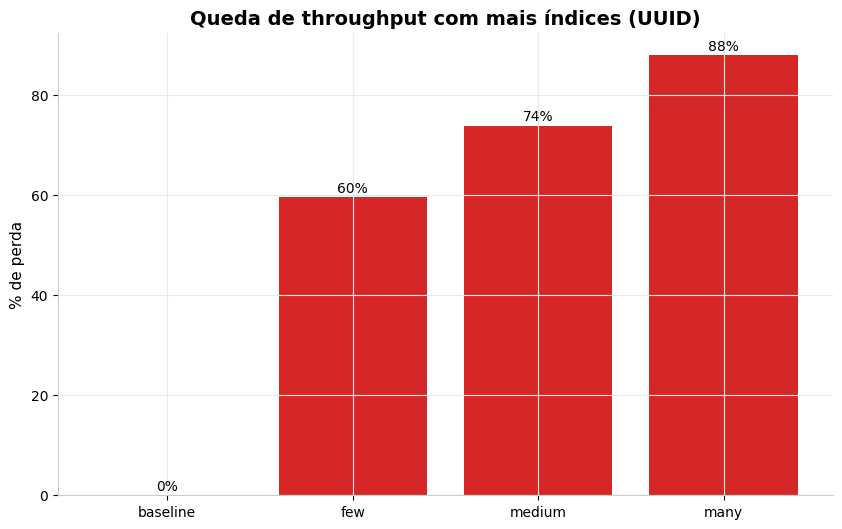
Queda de throughput com mais índice, UUID:
Com INT, a degradação é progressiva mas controlada:
- few (2 índices): -26% de throughput vs baseline
- medium (5 índices): -46%
- many (9 índices): -74%
O baseline começa em ~167.000 inserts/s e chega a ~45.000 no cenário many. Uma queda real, mas que ainda mantém throughput razoável.
Com UUID, o cenário é muito mais severo:
- few: -60%
- medium: -74%
- many: -88%
O baseline do UUID já começa mais baixo (~91.000 inserts/s) e despenca para ~11.000 no cenário many. Uma queda de quase 90% em relação ao ponto de partida.
A lição concreta não é “não use UUID”, é que usar UUID com qualidade exige pensar na estratégia de indexação junto. UUID v7 (ordenado por timestamp) ou UUID_TO_BIN(uuid, 1) no MySQL reduzem drasticamente o problema de fragmentação da B-Tree. O caminho não é abrir mão do UUID, é aplicá-lo com consciência.
Quando criar (e quando não criar) um índice
Crie um índice quando:
- A coluna aparece frequentemente em WHERE, JOIN ON ou ORDER BY
- A coluna tem alta cardinalidade (muitos valores distintos), indexar uma coluna booleana raramente vale a pena
- A tabela é lida muito mais do que escrita (sistemas OLAP, relatórios, consultas de leitura)
Evite ou repense um índice quando:
- A tabela recebe inserções/atualizações em alta frequência e volume
- Você está indexando colunas com baixa cardinalidade
- Você está adicionando índices “por precaução” sem saber quais queries vão usá-los
- O dado é UUID e a tabela é pesada em writes
EXPLAIN
Antes de criar um índice, use o EXPLAIN para entender o que o banco está fazendo:
EXPLAIN SELECT * FROM pedidos WHERE cliente_id = 42;Olhe para a coluna type. Se estiver ALL, você tem um full table scan. Se estiver ref ou range, um índice está sendo usado. A coluna key mostra qual índice foi escolhido.
Mas, e se ja temos muitos índices criados, qual o comando para ver quais nunca foram usados?
SELECT
    object_schema,
    object_name,
    index_name,
    count_star
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
ORDER BY count_star ASC;- count_star = 0 índice nunca foi usado desde que o servidor iniciou
- valores baixos indica índice quase nunca usado
- index_name = NULL acesso sem índice (full scan)
- Isso só conta desde o último restart do MySQL
- Se o performance_schema não estiver ativado, não funciona
- Pode ter índice “não usado” que ainda é crítico (ex: rodado 1x por semana em batch)
Conclusão
Índices não são gratuitos. Eles trocam performance de leitura por custo de escrita e espaço em disco. O ponto ótimo depende do seu padrão de uso.
A recomendação prática é sempre a mesma, meça antes de decidir. Use EXPLAIN, analise o padrão de queries do seu sistema, e teste os impactos.
O código está aberto e disponível para você rodar no seu próprio ambiente: github.com/francocontigo/index-insert-mysql-benchmark