UUID v1, v4, v6, v7 e Snowflake no MySQL e um pouco mais
No artigo anterior, mostrei o custo de cada índice extra nos seus INSERTs e como UUID muda essa conta. A conclusão foi que índices não são gratuitos, e UUID amplifica o problema.
Mas aquela análise comparava apenas INT vs UUID (v4). E no mundo real, “UUID” não é uma coisa só. Existem seis versões relevantes, cada uma com trade-offs diferentes. Além disso, existe o Snowflake ID, que nem UUID é e em muitos cenários é a melhor escolha.
Esse artigo nasceu de uma pergunta simples, “se UUID v7 é time-ordered ele se comporta como INT AUTO_INCREMENT no MySQL?”. A resposta curta, quase. A resposta longa é este artigo.
Fiz um benchmark com 6 tipos de identificadores, 4 cenários de índice, 7 estratégias de INSERT e 5 tipos de SELECT.
O resultado? UUID não é vilão. O vilão é usar UUID v4 como CHAR(36) sem pensar na estratégia de indexação junto.
Entendendo cada tipo de identificador
Se você já sabe a diferença entre v1, v4, v6, v7 e Snowflake, pode pular para a B-Tree, como-o-mysql-armazena-tudo-isso-por-dentro. Se não, essa seção explica porque a escolha do tipo de ID é uma decisão de arquitetura que vai te acompanhar por anos.
INT AUTO_INCREMENT, o clássico que ainda funciona
O bom e velho inteiro sequencial. O MySQL gera, é sequencial por natureza, ocupa 4 bytes (INT) ou 8 bytes (BIGINT). Inserts sempre vão pro final da B-Tree. Zero page splits. É a referência de performance contra a qual tudo é medido.
O problema aparece quando seu sistema cresce. Se você tem 3 microsserviços gerando pedidos ao mesmo tempo, cada um falando com um banco diferente, quem coordena os IDs? Você precisa de algum mecanismo centralizado, um ticket server, ou ranges pré-alocados, ou alguma forma de lock distribuído. Isso adiciona complexidade e ponto único de falha.
Além disso, IDs sequenciais são previsíveis. Um atacante pode iterar GET /api/users/1, /2, /3 e descobrir quantos usuários você tem, qual a taxa de crescimento e acessar registros que não deveria ver (se a autorização estiver fraca). Parece improvável? A OWASP lista “Insecure Direct Object References” como uma das vulnerabilidades mais comuns em APIs.
UUID v1 timestamp + MAC address (RFC 4122, 2005)
A primeira tentativa de resolver o problema do ID distribuído. O v1 combina um timestamp de alta precisão (100 nanossegundos, usando o calendário Gregoriano com epoch em 15 de outubro de 1582) com o MAC address da máquina geradora. Isso garante unicidade sem coordenação central, se cada máquina tem um MAC diferente e o clock não volta, os UUIDs nunca colidem.
Mas tem dois problemas.
Privacidade, o MAC address da sua máquina fica embutido no UUID. A RFC 9562 é direta sobre isso, “Exposed MAC addresses can be used as an attack surface to locate network interfaces and reveal various other information about such machines”. E com VMs e containers, o MAC já nem garante unicidade de verdade.
Performance no MySQL, aqui é onde fica interessante. Os bits do timestamp no v1 ficam embaralhados. A estrutura é time_low(32 bits) + time_mid (16 bits) + time_hi_and_version (16 bits). O time_low é a parte menos significativa do timestamp, e ele vem primeiro. Resultado, dois UUIDs v1 gerados em sequência podem ter os primeiros 32 bits completamente diferentes, porque a parte que mais muda (time_low) é a que lidera.
O MySQL tem o UUID_TO_BIN(uuid, 1) com swap flag que reordena os bytes do timestamp para ficarem na ordem certa. Mas é uma conversão manual, você precisa lembrar de aplicar em todo INSERT e todo SELECT. Esqueceu o swap flag numa query? Full scan.
UUID v4 — puro aleatório (RFC 4122, 2005)
122 bits de pura aleatoriedade. Nenhum timestamp, nenhum MAC, nenhuma informação sobre quando ou onde foi gerado. Máxima privacidade, e o mais simples de implementar, toda linguagem tem uuid4() nativo.
E máximo custo de performance. Cada INSERT cai numa posição aleatória da B-Tree. Para entender por que isso é tão ruim, vamos para o InnoDB e ver como ele gerencia páginas de dados.
O InnoDB organiza os dados em pages de 16KB. Quando a PK é sequencial, ele enche cada page até ~94% antes de criar a próxima, é o fill factor ótimo. Com UUID v4 aleatório, cada novo INSERT pode cair em qualquer page. Se a page destino já está cheia, o InnoDB faz um page split, divide a page em duas, cada uma com ~50% de ocupação. Em tabelas grandes, isso significa:
- **Dobro do espaço em disco,**pages 50% cheias vs 94% cheias.
- **Mais I/O por query,**precisa ler mais pages para achar os mesmos dados.
- **Buffer pool menos eficiente,**mais pages = mais cache miss.
A Percona documentou um caso, uma tabela com 1 bilhão de rows e UUID v4 como CHAR(36) ocupava quase 1 TB. Depois de reorganizar com chave ordenada, caiu para ~450 GB. Metade. O fill factor das index pages era de ~50% com UUID aleatório vs ~90% com chave sequencial.
UUID v6 — o v1 arrumado (RFC 9562, 2024)
Em maio de 2024, a IETF publicou a RFC 9562, a primeira atualização da especificação de UUID em quase 20 anos. Uma das motivações explícitas foi o problema de performance em bancos de dados:
“UUID versions that are not time ordered, such as UUIDv4, have poor database-index locality. This means that new values created in succession are not close to each other in the index.”
O v6 é a solução mais conservadora, pega os mesmos dados do v1 (timestamp Gregoriano + node/MAC), mas reordena os bits do timestamp para que os mais significativos venham primeiro. Resultado, UUIDs v6 são naturalmente sortable sem precisar de swap flag.
A RFC é direta sobre quando usar, “Systems that do not involve legacy UUIDv1 SHOULD use UUIDv7 instead”. Ou seja, v6 existe como ponte de migração para quem já tem v1 em produção. Se está começando do zero, pule direto para o v7.
UUID v7, a recomendação moderna (RFC 9562, 2024)
48 bits de timestamp Unix (milissegundos) nos bits mais significativos + 74 bits de randomness. Sem MAC address, sem informação de hardware. Privado e sortable.
Os 48 bits de timestamp dão resolução de 1 milissegundo e cobrem até o ano 10.889. Se dois UUIDs v7 são gerados no mesmo milissegundo, a parte random (rand_a + rand_b = 74 bits) garante unicidade. Algumas implementações usam um counter monotônico nos bits de rand_a para garantir ordenação total mesmo dentro do mesmo milissegundo.
Na prática, o v7 se comporta quase como um AUTO_INCREMENT para o InnoDB, inserts sempre vão para o final da B-Tree, pages ficam com fill factor ótimo, zero page splits. A diferença é que ele garante unicidade global sem coordenação.
A adoção está acelerada. O PostgreSQL 18 adicionou uuidv7() nativo. O Python 3.14 adicionou uuid.uuid7() na stdlib. Java, Go, Rust e JavaScript já têm bibliotecas maduras.
Snowflake ID, a solução do Twitter (2010)
Em 2010, o Twitter enfrentou um problema concreto, precisava migrar do MySQL para o Cassandra para escalar, mas o Cassandra não tem AUTO_INCREMENT. O time de engenharia publicou o post “Announcing Snowflake” no blog técnico e abriu o código.
Os requisitos eram simples mas exigentes, “We needed something that could generate tens of thousands of ids per second in a highly available manner […] these numbers have to fit into 64 bits”.
A solução: Um ID de 64 bits (metade de um UUID) composto por:
- 1 bit reservado sempre 0, para manter o número positivo como signed int.
- 41 bits de timestamp, milissegundos desde epoch customizado -> ~69 anos.
- 10 bits de machine ID, até 1.024 máquinas.
- 12 bits de sequence, até 4.096 IDs por milissegundo por máquina.
O Twitter usa epoch de 4 de novembro de 2010. O Discord usa 1 de janeiro de 2015. O Instagram usa uma variação com 41 bits timestamp + 13 bits shard ID + 10 bits sequence.
As vantagens são claras: sequencial (inserts ordenados), compacto (cabe num BIGINT de 8 bytes, metade de um UUID), rápido de gerar (sem crypto random necessário), e o timestamp embutido elimina a necessidade de uma coluna created_at separada.
O trade-off? Você precisa gerenciar machine IDs. Num cluster Kubernetes dinâmico, isso é trabalho extra (o paper “Stateless Snowflake” do Arxiv aborda soluções para isso). E os 64 bits dão “apenas” ~4,6 × 1⁰¹⁸ IDs possíveis, contra ~5,3 × 1⁰³⁶ do UUID v4. Na prática, sobra.
E o ULID?
Vale mencionar o ULID (Universally Unique Lexicographically Sortable Identifier), que é parecido com UUID v7, 48 bits de timestamp + 80 bits de random, codificado em Crockford Base32. A diferença principal é que ULID tem 80 bits de randomness (vs 74 do v7) e usa uma codificação mais legível. Mas ULID não é UUID, não cabe num campo UUID de banco de dados e não tem RFC padronizando. Com a chegada do v7 na RFC 9562, a recomendação é clara, se vai usar o formato UUID, use v7. Se quer algo mais compacto, considere Snowflake.
Como o MySQL armazena tudo isso por dentro
Antes de ir para os números, vale entender o mecanismo por trás. Essa seção explica por que o tipo de ID impacta tanto e por que muita gente esquece o custo.
B+Tree e Clustered Index
O InnoDB usa uma estrutura chamada B+Tree para organizar dados e índices. Em uma B+Tree, os dados ficam nas folhas (leaf nodes) e os nós internos armazenam ponteiros para navegação. A busca é logarítmica, para 1 milhão de rows, são ~3-4 níveis de nós para chegar no dado.
O detalhe crucial, no InnoDB, a Primary Key define o clustered index. Isso significa que os dados da tabela são armazenados fisicamente na ordem da PK. Não é uma coincidência, é a organização física no disco. Quando você insere uma row com PK = 42, ela vai parar fisicamente entre as rows 41 e 43.
Isso tem consequências:
- Com PK sequencial (INT AUTO), inserts vão sempre para o final, append-only, rápido.
- Com PK aleatória (UUID v4), inserts vão para posições aleatórias, obriga o InnoDB a ler pages antigos do disco, modificar, e reescrever.
Page Splits, o custo
O InnoDB aloca dados em pages de 16KB. Quando uma page está cheia e um novo dado precisa ser inserido nela, o InnoDB executa um page split, cria uma nova page, move metade dos dados para ela, e insere o novo dado. Cada page fica com ~50% de ocupação.
Com PK sequencial, isso raramente acontece, o InnoDB enche uma page até ~94% e começa a próxima. Com PK aleatória, page splits são constantes, porque qualquer page pode ser o alvo.
O impacto é multiplicativo:
- Espaço, pages com 50% fill vs 94% fill = quase 2x mais espaço em disco.
- I/O, mais pages = mais leituras de disco para a mesma query.
- Buffer Pool, o InnoDB mantém pages frequentemente acessadas em memória (buffer pool). Com mais pages espalhadas, o hit ratio cai.
O custo, índices secundários carregam a PK
No InnoDB, cada entrada de um índice secundário armazena a PK da row como ponteiro. Isso significa que se sua PK é um UUID de 16 bytes (BINARY(16)) e você tem 5 índices secundários, cada row armazena a PK 6 vezes no total, uma no clustered index + uma em cada índice secundário.
Com CHAR(36), são 36 bytes por cópia. Com 9 índices, são 10 cópias × 36 bytes = 360 bytes só de chave por row. Mudando para BINARY(16), cai para 10 × 16 = 160 bytes. E com INT (4 bytes), são apenas 10 × 4 = 40 bytes.
Por isso o PlanetScale recomenda em seu curso MySQL for Developers, “unsigned big integers are the most reliable and performant data type” para PKs.
CHAR(36) vs BINARY(16): nunca use CHAR(36)
Se você está armazenando UUID como CHAR(36) em produção, está desperdiçando 56% do espaço desnecessariamente. E esse desperdício se multiplica por cada índice.
-- ERRADO, 36 bytes por UUID, comparação de string
CREATE TABLE users (
    id CHAR(36) PRIMARY KEY,
    ...
);

-- CORRETO, 16 bytes por UUID, comparação binária (mais rápida)
CREATE TABLE users (
    id BINARY(16) PRIMARY KEY,
    ...
);

-- Para converter na aplicação
INSERT INTO users (id) VALUES (UNHEX(REPLACE('550e8400-e29b-41d4-a716-446655440000', '-', '')));
SELECT HEX(id) FROM users;
Neste benchmark, todos os UUIDs são BINARY(16). Os números que você vai ver já são o cenário otimizado. Com CHAR(36), tudo seria significativamente pior.
Metodologia
Ambiente
- Docker MySQL 8.0 com, — memory=1g (hard limit para evitar swap do host).
- innodb-buffer-pool-size=256M, innodb-log-file-size=64M.
- performance-schema=OFF (economiza ~200MB de RAM).
- Windows 11, Docker Desktop.
- Python 3.11, 4 threads, mysql-connector-python.
- Todos os UUIDs gerados **client-side,**não usa UUID() do MySQL.
Por que trimmed mean e não média simples?
Em benchmarks de I/O, outliers são comuns, uma coleta de lixo do OS, um flush do Docker, um background scan do antivírus. Uma única run ruim pode distorcer a média em 50%+.
A solução, 7 runs por cenário, descartamos o melhor e o pior tempo, e calculamos a média dos 5 restantes (trimmed mean). Isso dá resultados muito mais estáveis que a média simples, nosso StdDev caiu de ~30% para ~5% na maioria dos cenários.
Cada cenário também tem um warmup descartável de 10k rows antes das medições reais, para aquecer o InnoDB buffer pool e eliminar o efeito “cold start”.
Otimizações para Windows
O Windows/NTFS é notoriamente mais lento para operações de fsync que Linux/ext4. Para reduzir variância sem comprometer os resultados:
- innodb_flush_log_at_trx_commit = 2, flush assíncrono do redo log (o default = 1 faz fsync síncrono por commit).
- sync_binlog = 0,binlog assíncrono.
- gc.collect() + sleep(1s) entre cenários para estabilizar I/O do NTFS.
Importante, essas configurações são para benchmark. Em produção, mantenha innodb_flush_log_at_trx_commit = 1 para durabilidade.
Cenários de índice
- baseline, Só PK, nenhum índice secundário.
- **few,**idx_a, idx_b (simples).
- medium, 4 simples + 1 composto (col_a, col_b).
- **many,**6 simples + 3 compostos.
O que foi medido
- Parte 1, INSERT, 6 tipos de ID × 4 cenários × 2 volumes (50k, 200k).
- Parte 2, INSERT, 7 estratégias de batch (100, 1k, 5k, 10k, multi-row, sort prévio, sort+multi-row) × 4 tipos × 4 cenários.
- **Parte 3,**SELECT, 5 tipos de query × 6 tipos de ID × 4 cenários.
Todo o código: https://github.com/francocontigo/index-insert-mysql-benchmark
Parte 1: INSERT, Tipos de ID
Throughput vs Índices (200k rows)
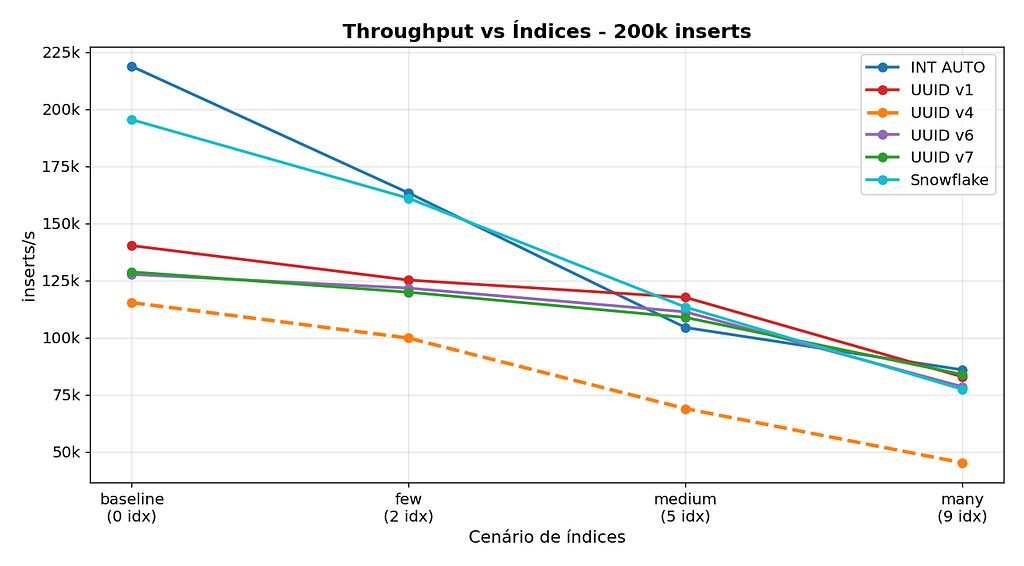
A primeira coisa que da para perceber, INT AUTO e Snowflake dominam no baseline, mas todos convergem conforme os índices aumentam.
1° Observação: UUID v7 é o mais resiliente a índices
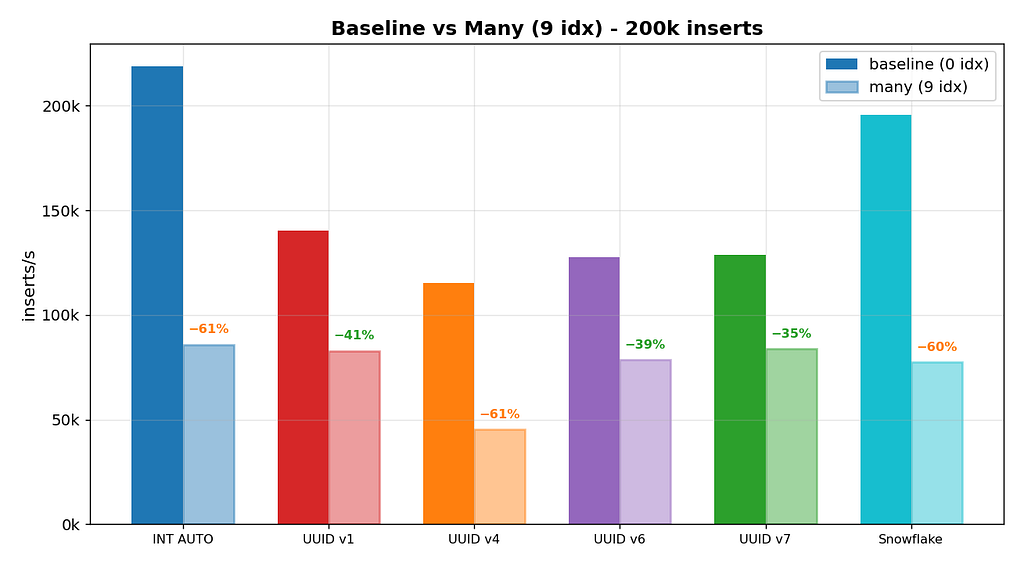
Olhando a coluna de queda, v7 perde apenas 35% do throughput ao ir de zero para 9 índices. O INT AUTO perde 61%.
Como isso é possível?
A explicação é sutil. INT AUTO começa com throughput muito alto (219k/s) porque o baseline é trivial, append-only, sem trabalho nos índices. Quando você adiciona 9 índices, o custo de manutenção dos índices domina. E como as colunas no benchmark são do mesmo tipo da PK, com INT os índices secundários também são INT (4 bytes) rápido de manter, mas o custo absoluto é alto porque o baseline era altíssimo.
Com UUID v7, o baseline já é mais baixo (129k/s) porque BINARY(16) é maior. Mas como v7 é sequencial, os page splits nos índices secundários são mínimos. O custo de adicionar um índice é quase só a escrita linear na B-Tree, sem a fragmentação cascata que acontece com v4.
O v4 tem o pior dos dois mundos, baseline mais baixo e queda acentuada. Aleatoriedade na PK + aleatoriedade nos índices secundários = fragmentação em todas as estruturas.
2° Oservação: Com muitos índices, o tipo de ID importa menos
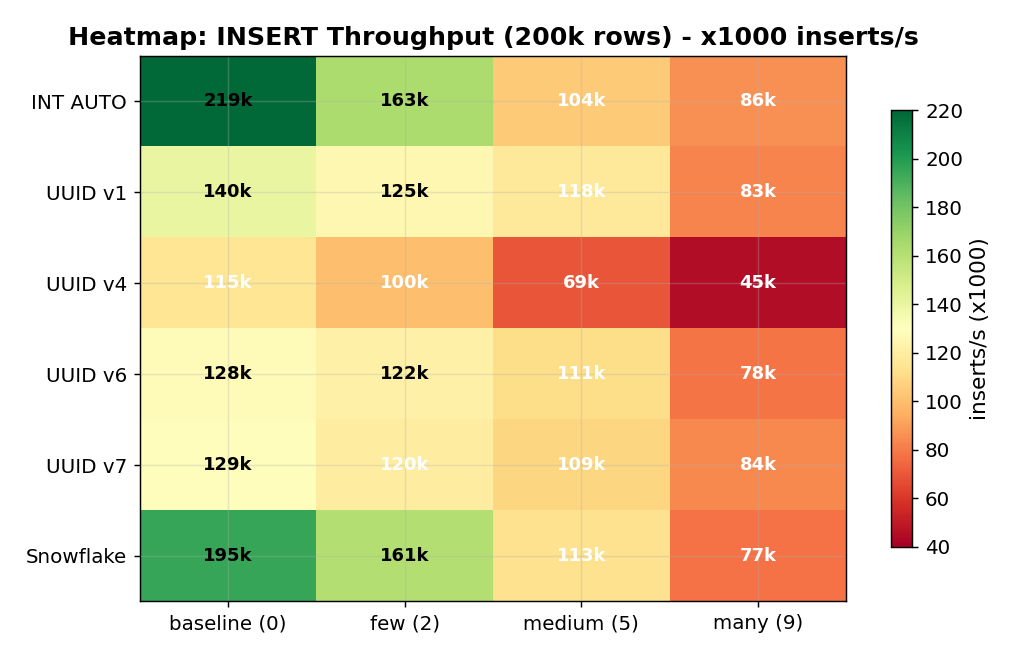
Repare na coluna “many (9)” do heatmap: INT (86k), v1 (83k), v7 (84k), v6 (78k), Snowflake (77k), todos entre 77–86k/s. A exceção é o v4 (45k).
Isso faz sentido. Com 9 índices, cada INSERT faz efetivamente 10 escritas (1 na tabela + 9 nos índices). O custo de I/O dos índices domina. A diferença entre “PK sequencial rápida” e “PK sequencial um pouco mais lenta” fica pequena quando o gargalo é a manutenção de 9 B-Trees.
A lição, o tipo de ID importa muito quando você tem poucos índices (onde a PK domina o custo). Com muitos índices, todos sofrem de forma parecida, exceto o v4, que sofre mais porque fragmenta tudo.
3° Observação: 50k vs 200k, o volume amplifica a diferença
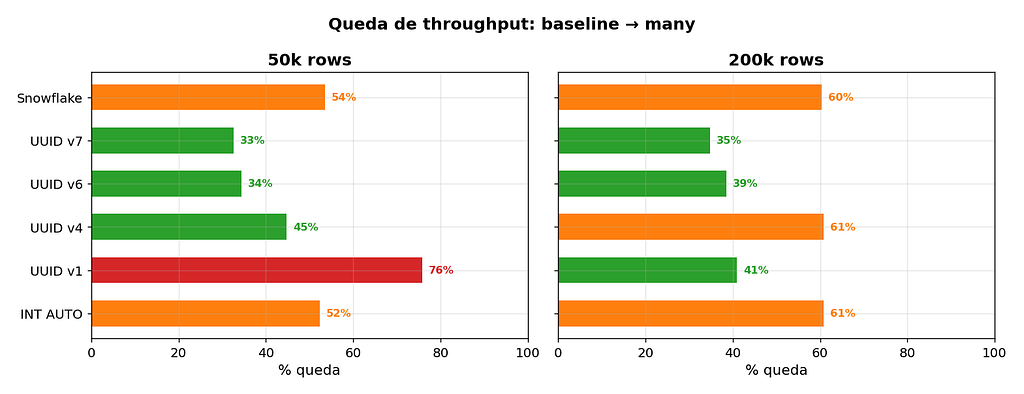
Com 50k linhas, as diferenças são menores e mais ruidosas, a tabela cabe inteira no buffer pool e muitos page splits são absorvidos em memória. Com 200k, o buffer pool começa a ter evictions e o padrão de I/O real aparece.
Se seu sistema tem tabelas com milhões de linhas (e provavelmente tem), a diferença será ainda mais pronunciada que os números aqui.
Parte 2: INSERT, estratégias otimizadas
Mesmos tipos de ID, mas agora variando a técnica de inserção. A pergunta surge:
O que dá mais resultado, mudar o tipo de ID ou mudar a forma de inserir?
4° Observação: Batch size, o salto de 100 para 1000 linhas é o que mais importa
Ir de batch 100 para batch 1000 dá um salto de 40–75% de throughput. Depois de 1000, o ganho é incremental. E o multi-row VALUES (single SQL com 5000 values) é consistentemente o mais rápido.
Por que batch 100 é tão ruim? Cada commit no InnoDB faz (com configuração padrão) um fsync do redo log. Com batch 100, são 2.000 commits para inserir 200k rows. Com batch 5000, são apenas 40 commits. Menos fsync = menos espera por I/O = mais throughput.
5° Observação: Com 9 índices: batch grande continua valendo
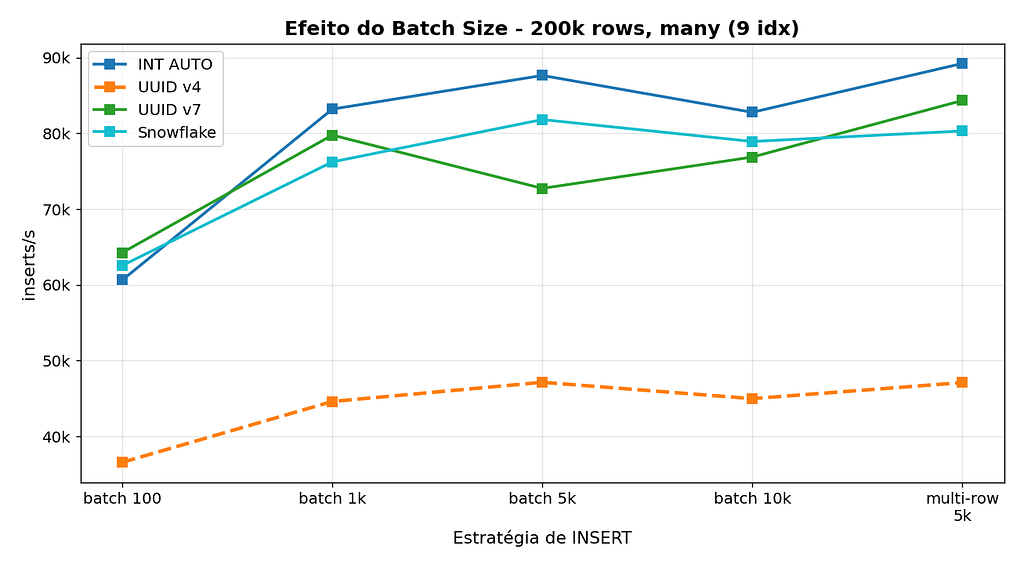
Com 9 índices, o throughput absoluto cai, mas o padrão se mantém. Multi-row VALUES e batch 5k continuam no topo. E novamente, v4 fica isolado lá embaixo.
Um ponto, batch 10k não é necessariamente melhor que batch 5k. Em vários cenários, 10k foi ligeiramente mais lento. O motivo provável é que o MySQL precisa alocar mais memória para o statement e o overhead de parsing de um SQL com 10.000 VALUES começa a pesar. O sweet spot é entre 1.000 e 5.000 para a maioria dos cenários.
6° Observação: UUID v4 comsort prévio ajuda, mas não resolve
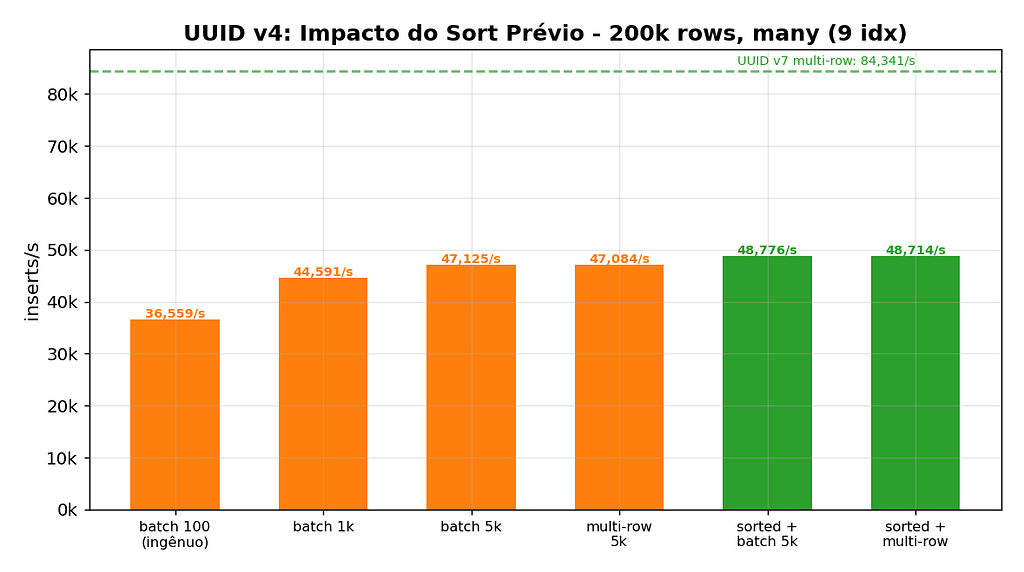
A ideia é, se o v4 é aleatório e isso causa page splits, o que acontece se ordenamos os dados antes de inserir? Os dados vão chegar na B-Tree em ordem crescente, minimizando splits.
A linha tracejada verde no gráfico conta que UUID v7 com multi-row atinge 84.341/s no mesmo cenário. O v4 otimizado ao máximo ainda fica 42% abaixo do v7 padrão.
A lição, sort prévio é uma boa prática se você está preso no v4 e não pode migrar. Mas **se pode escolher, escolha v7,**é a otimização que se paga sozinha.
7° Observação: Comparações, a melhor config pra cada tipo
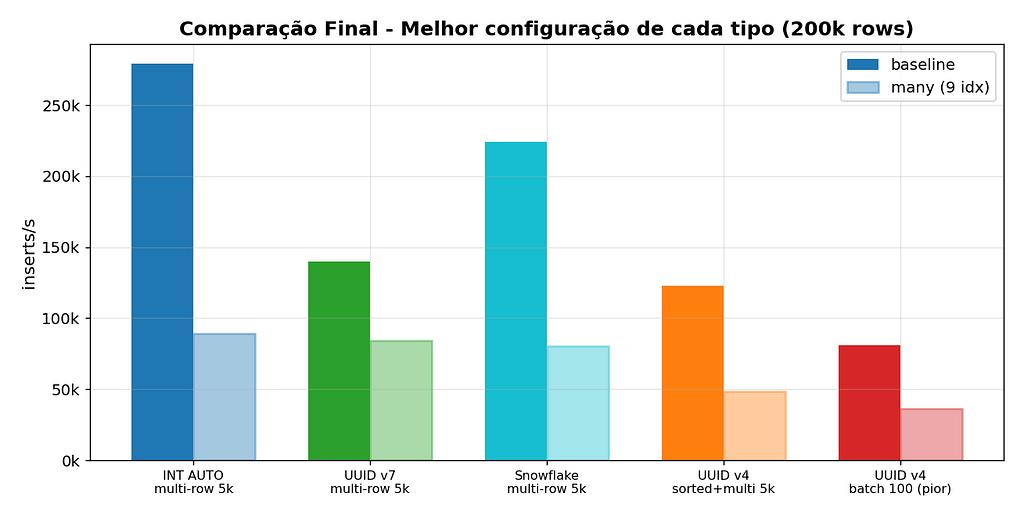
O ranking final para 200k rows, cenário many (9 índices), melhor estratégia de cada tipo:
- INT AUTO multi-row 5k: 89k/s
- UUID v7 multi-row 5k: 84k/s (−6% vs INT)
- Snowflake batch 5k: 82k/s (−8% vs INT)
- UUID v4 sorted batch 5k: 49k/s (−45% vs INT)
UUID v7 fica a apenas 6% do INT AUTO_INCREMENT no cenário mais pesado. É um “imposto” aceitável para ganhar unicidade global, distribuição sem coordenação e privacidade de ID.
Parte 3: SELECT, CANSEI DE FALAR DE INSERT EM NOME DE DEUS
Até agora só falamos de escrita. Mas índice existe para acelerar leitura. O trade-off só faz sentido quando olhamos os dois lados.
8° Observação: Point Lookup 56-76x mais rápido com índice
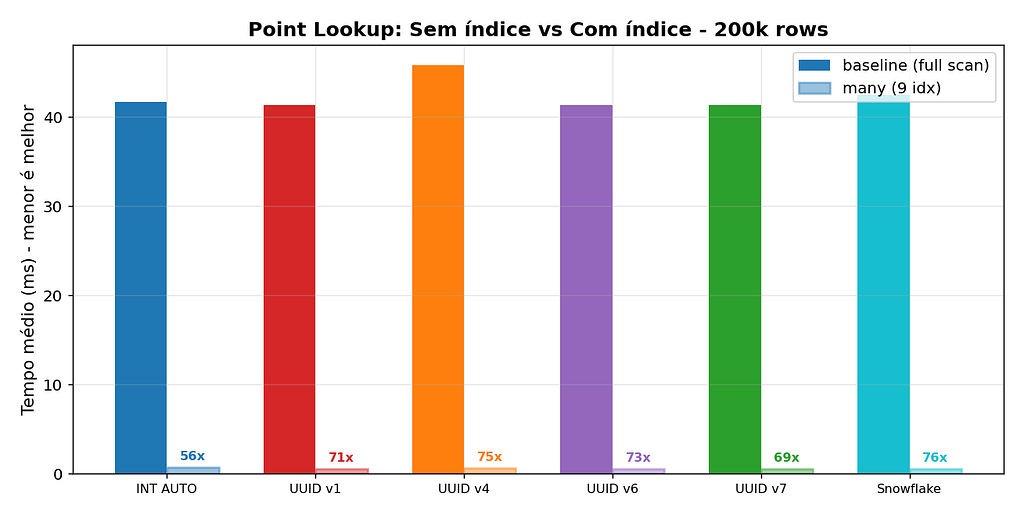
Sem índice (baseline), um WHERE col_a = X faz full table scan em ~42ms. Com qualquer número de índices, cai para ~0.6ms. Um speedup de 56-76x dependendo do tipo.
E aqui mais uma coisa aparece, com índice, a diferença entre tipos de ID desaparece. INT, UUID v4, UUID v7, Snowflake, todos ficam em ~0.6ms. O tipo de dado importa para escrita, para point lookup com índice, é irrelevante.
O motivo é que o point lookup percorre o índice secundário (B-Tree com poucos níveis) e depois faz um bookmark lookup na PK para buscar a row completa. O tamanho da PK importa para o tamanho do índice (espaço em disco), mas a latência de um único lookup é dominada pelo número de níveis da árvore, que é o mesmo para todos.
9° Observação: COUNT + GROUP BY, o ganho mais dramático com índices
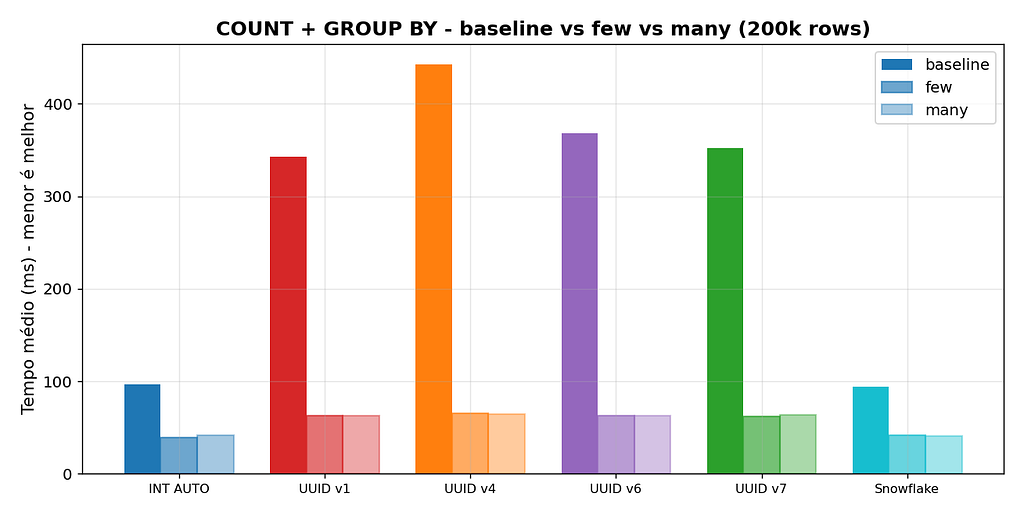
Essa é a query que mais se beneficia de índices.
INT/Snowflake já são relativamente rápidos sem índice (96ms vs 443ms do v4). Isso porque INT ocupa 4 bytes vs 16 bytes do BINARY(16). Mais rows cabem numa page de 16KB, mais pages cabem no buffer pool, menos I/O. O tamanho do dado tem efeito direto no scan.
Com índice, o gap diminui mas não desaparece (42ms vs 65ms). GROUP BY com índice usa index scan (percorre o índice em ordem), e o tamanho das entradas do índice importa, BINARY(16) tem 4x mais bytes por entrada que INT.
10° Observação: Range Scan, onde o tamanho do dado incomoda
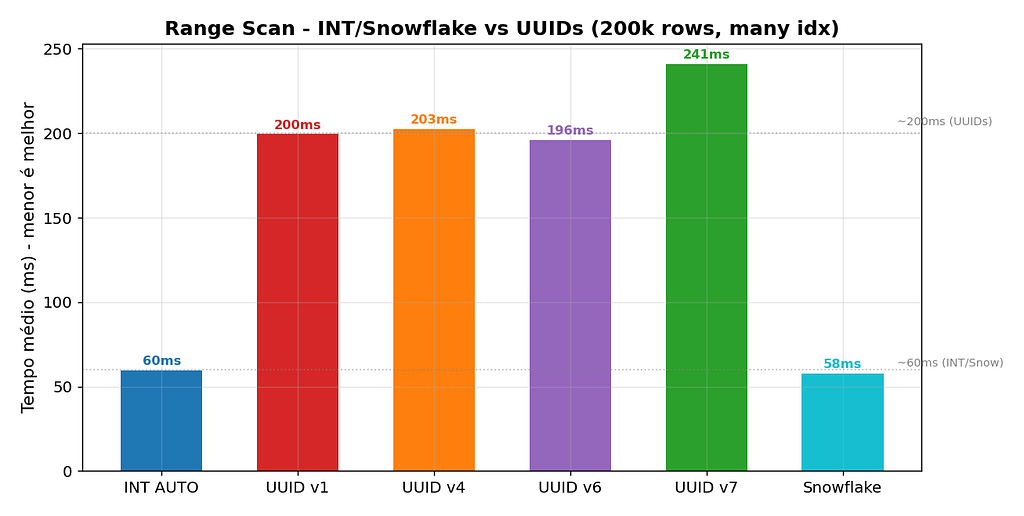
Aqui a diferença é insana e não depende do número de índices:
- INT / Snowflake: ~58ms
- Todos os UUIDs (v1, v4, v6, v7): ~200ms
3.5x mais lento, consistentemente. O motivo é estrutural: um range scan lê pages sequenciais do disco (ou buffer pool). Com BINARY(16), cada row + colunas auxiliares é significativamente maior. Mais dados = mais pages = mais tempo.
Isso é um custo inerente ao UUID como tipo de dado, independe da versão. Se sua aplicação faz muitas range scans em colunas BINARY(16), considere uma estratégia híbrida: PK como UUID v7 (para unicidade distribuída), mas colunas de filtro e busca como INT quando possível.
Analisando o Trade-Off
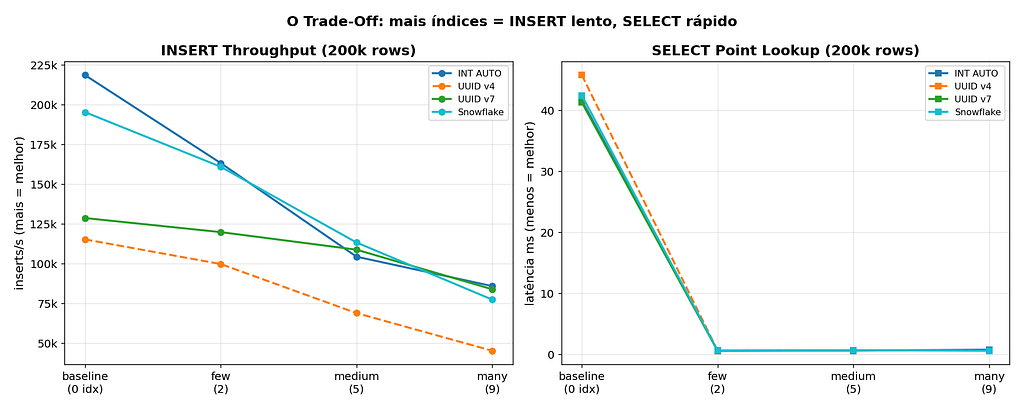
Esse é o meu queridinho do artigo. À esquerda, INSERT throughput cai conforme os índices aumentam. À direita, SELECT latency cai (melhora) com a mesma progressão.
Três analises desse gráfico:
- O salto baseline para few (2 índices) é assimétrico. O custo de INSERT é de ~25%. O ganho de SELECT é de ~98% (42ms para0.6ms no point lookup). Dois índices bem escolhidos são o melhor investimento em performance que existe.
- **Depois de “few”, os retornos de SELECT são decrescentes.**De few para medium para many, o point lookup praticamente não muda (0.6ms para 0.6ms para 0.7ms). O que melhora um pouco é ORDER BY (51ms para 44ms para 26ms, porque mais cenários de query são cobertos). Mas o custo de INSERT continua crescendo linearmente.
- UUID v4 paga o maior preço. Ele começa mais baixo e cai mais rápido. No cenário many, fica em 45k/s, quase metade do v7 (84k/s). Para leitura, a performance é similar a todos os outros. Ou seja, v4 paga mais de INSERT sem ganhar nada de SELECT.
De lição, 2-4 índices bem escolhidos (baseados em queries reais, não especulação) cobrem 90%+ dos cenários. 9 índices “por precaução” custam 60% de throughput de escrita para um ganho marginal de leitura.
Recomendações da minha cabeça
Ou, o que eu levo de lição daqui.
Qual tipo de ID usar?
Precisa de unicidade global + distribuído?
UUID v7 se quer padrão RFC e máxima compatibilidade. Snowflake se quer performance máxima, 8 bytes, e consegue gerenciar machine IDs.
Não precisa de distribuído?
INT AUTO_INCREMENT ou BIGINT AUTO_INCREMENT. Simples, rápido, 4–8 bytes. Validado há décadas.
Já usa UUID v4 em produção e não pode migrar?
Pelo menos mude de CHAR(36) para BINARY(16), ganho imediato de 56% de espaço, use batch inserts de 1000+, ordene os dados antes de inserir quando possível. Considere uma migração gradual para v7 os dois formatos coexistem no mesmo campo BINARY(16).
Nunca use UUID v1 em projetos novos. A RFC 9562 recomenda v7 explicitamente. v1 só faz sentido para compatibilidade com sistemas legados.
Como fazer INSERT da melhor forma
- BINARY(16) para UUIDs, não CHAR(36). Sempre.
- Gere o ID client-side, não no MySQL. UUID() do MySQL só gera v1 (com MAC exposto) e é mais lento que gerar na aplicação.
- Batch de 1.000+ rows por commit. O salto de 100 para 1000 é o maior ganho.
- Multi-row VALUES quando possível, INSERT INTO t (a,b) VALUES (1,2), (3,4), (5,6) é mais rápido que executemany na maioria dos drivers porque envia um único SQL.
- Se usar v4, ordene antes de inserir. Não é tão bom quanto v7, mas reduz page splits.
- Em cargas massivas (>500k linhas), considere LOAD DATA INFILE com staging table + UNHEX().
Como auditar seus índices
Antes de criar um índice, use o EXPLAIN:
EXPLAIN SELECT * FROM pedidos WHERE cliente_id = 13;Se type = ALL, é full scan, candidato a índice. Se type = ref ou range, um índice já está sendo usado.
Para encontrar índices que nunca foram usados:
SELECT object_schema, object_name, index_name, count_star
FROM performance_schema.table_io_waits_summary_by_index_usage
WHERE index_name IS NOT NULL
ORDER BY count_star ASC;
count_star = 0, índice nunca acessado desde o último restart. Candidato a remoção. Mas verifique se não é um batch semanal ou relatório mensal antes de dropar.
**Cuidado,**o performance_schema precisa estar habilitado (está por padrão, mas consumimos ~200MB de RAM). Neste benchmark desabilitamos por restrição de memória do container.
Conclusão
UUID v7 é a melhor escolha para quem precisa de identificadores distribuídos. Degrada apenas 35% com 9 índices (vs 61% do v4), fica a 6% do INT no cenário mais pesado com estratégia otimizada, e a leitura indexada é idêntica a todos os outros tipos.
Se precisa de range scan rápido e não precisa de distribuído, Snowflake é imbatível, 8 bytes, sequencial, 58ms de range scan (vs 200ms dos UUIDs).
UUID não é vilão. O vilão é usar v4 aleatório como CHAR(36) sem pensar na estratégia de indexação, sem batch adequado, sem medir o impacto.