Como decidir sua modelagem e entrega de dados
Star Schema vs One Big Table, quando engenharia de dados vira questão de virtude e esquecemos que a resposta está nos gargalos do negócio.
Toda discussão de modelagem de dados que eu vejo em time, em thread de LinkedIn ou em PR, acontece da mesma forma. De um lado, alguém solta que “star schema é coisa de quem aprendeu modelagem em 2008”. Do outro, alguém responde que “OBT é gambiarra de quem nunca manteve uma dimensão em produção”. Os dois acham que estão discutindo arquitetura. Estão discutindo, na verdade, economia de hardware, e nenhum dos dois percebeu que o terreno mudou.
Esse artigo nasceu de uma indignação minha com essa discussão. Eu queria um guia que colocasse 3NF, Data Vault, star schema, snowflake schema, OBT, medallion, as camadas do dbt e até tidy data no mesmo plano, e mostrasse que quase tudo isso é o mesmo eixo visto de ângulos diferentes. No fim, o que separa uma escolha boa de uma ruim não é qual nome você usa, é se você entendeu qual é o seu gargalo e quem precisa explorar o dado sem te incomodar.
Tem um número que abre bem a discussão. A Fivetran rodou OBT contra star schema nos três grandes warehouses colunares e mediu 25% a 50% de redução no tempo de query no Redshift, Snowflake e BigQuery, com menos consumo de computação. Se star schema é a “modelagem séria”, por que a versão “errada” ganha por uma margem dessas? A resposta é que star schema nunca foi sobre estar certo ou errado. Foi sobre um trade-off que fazia sentido numa época, e a época acabou.
Vamos por partes, porque tem duas confusões pra desfazer antes de qualquer coisa.
Confusão 1: forma não é a mesma coisa que camada
A maior parte das brigas acontece porque as pessoas misturam dois eixos completamente independentes.
O eixo da forma é sobre o formato físico/lógico das tabelas, o quanto você normaliza ou desnormaliza. 3NF, Data Vault, star schema, snowflake schema e OBT vivem todos aqui. É um espectro contínuo, do mais normalizado (zero redundância, tudo quebrado em tabelinhas) ao mais desnormalizado (uma tabela com tudo dentro).
O eixo da camada é sobre o estágio de refinamento do dado no pipeline: cru, limpo, servível. Bronze/silver/gold (medallion) e staging/intermediate/marts (dbt) vivem aqui. Não falam de forma, falam de maturidade e qualidade.
E tem um terceiro intruso, tidy data, que é a forma normal do analista, e que cruza com os dois eixos.
Por que isso importa? Porque “Kimball vs OBT” é uma escolha no eixo da forma, e “bronze/silver/gold” é uma escolha no eixo da camada, e elas se compõem em vez de competir. Você aplica Kimball dentro do gold. Você materializa um OBT como um mart. Quando alguém diz “a gente usa medallion em vez de Kimball”, está dizendo algo tão estranho quanto “a gente usa quilômetro em vez de quilo”. São unidades de coisas diferentes.
Agora, pra próxima.
Confusão 2: “mais desnormalizado” não é “mais moderno”
A outra leitura errada é tratar o eixo da forma como uma linha do tempo de progresso, como se 3NF fosse o passado atrasado e OBT fosse o futuro inevitável, e normalizar fosse um estágio primitivo que a humanidade superou. Não é progresso, é pêndulo.
A 3NF não foi aposentada, ela ainda manda no OLTP, onde integridade de escrita é tudo. O Data Vault 2.0 (2013) e o anchor modeling (paper de 2009) são bem mais recentes que o star schema e puxam pro lado normalizado, não pro desnormalizado. E, como você vai ver mais pra frente, o semantic layer está literalmente puxando a modelagem de volta pro lado normalizado.
O eixo não é uma seta de mão única do “antigo” pro “moderno”, é um pêndulo que oscila conforme a economia do hardware muda.
Tratar a forma como progresso é exatamente como se entope um OBT num lugar que pedia star schema, por moda, não por objetivo.
O eixo da forma: cada nome é um ponto, escolhido por um gargalo
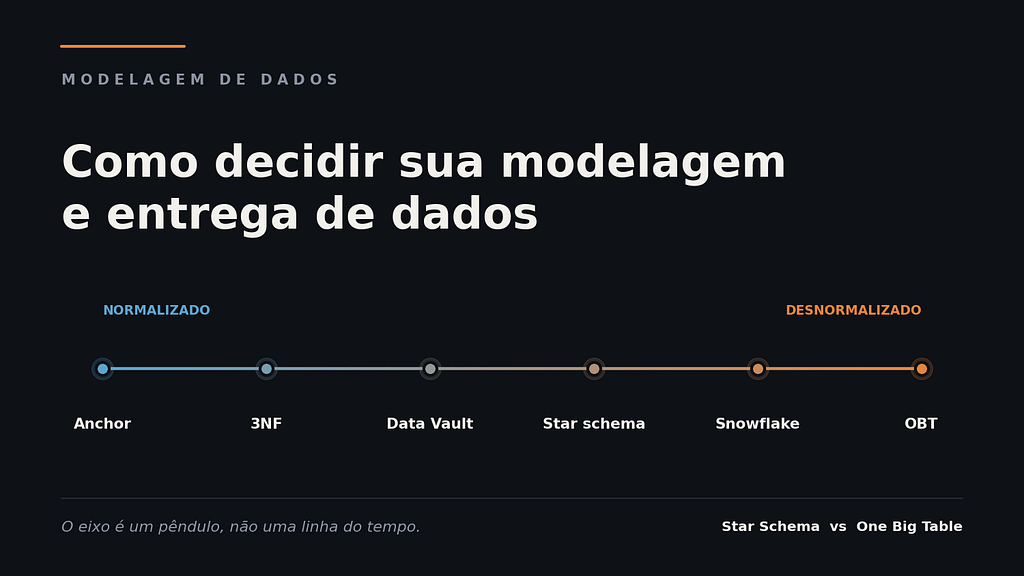
Eixo horizontal de modelagem de dados, do mais normalizado (Anchor, 3NF, Data Vault) ao mais desnormalizado (Star schema, Snowflake, OBT), em gradiente azul para laranja.
Vou percorrer o espectro do mais normalizado pro mais desnormalizado, e em cada parada a pergunta é sempre a mesma, que custo essa escolha estava tentando minimizar?
3NF e Inmon, integridade de escrita acima de tudo
A terceira forma normal é o ponto mais à esquerda. Zero redundância, cada fato armazenado uma única vez, tudo quebrado em tabelas relacionadas por chave. É o mundo do OLTP, do banco transacional. O gargalo que a 3NF minimiza é o custo da escrita inconsistente, se o endereço do cliente está em um lugar só, você nunca tem dois endereços divergentes. Atualiza um, atualiza todos.
Bill Inmon levou essa filosofia pro data warehouse com a Corporate Information Factory, a abordagem top-down, você constrói primeiro um EDW corporativo normalizado em 3NF, a única fonte da verdade, e só depois deriva data marts dependentes pra cada área. É robusto e caro de começar. Você precisa modelar a empresa inteira antes de entregar o primeiro dashboard.
O problema da 3NF pra analytics é simples, responder “faturamento por categoria por região no último trimestre” exige juntar uma dúzia de tabelas. Em OLTP, isso é o preço da consistência. Em OLAP, é o gargalo principal.
-- 3NF, cada fato uma vez só, ligado por chave
CREATE TABLE cidade  (cidade_id INT PRIMARY KEY, nome VARCHAR(80), uf CHAR(2));
CREATE TABLE cliente (cliente_id INT PRIMARY KEY, nome VARCHAR(120),
                      cidade_id INT REFERENCES cidade(cidade_id));
CREATE TABLE pedido  (pedido_id INT PRIMARY KEY, data DATE, valor NUMERIC(12,2),
                      cliente_id INT REFERENCES cliente(cliente_id));

-- "faturamento por UF" exige juntar pedido -> cliente -> cidade
SELECT ci.uf, SUM(p.valor)
FROM pedido p
JOIN cliente c ON c.cliente_id = p.cliente_id
JOIN cidade ci ON ci.cidade_id = c.cidade_id
GROUP BY ci.uf;
Data Vault, quando a fonte muda toda semana
Um passo pra direita, mas com uma filosofia própria. O Data Vault foi criado por Dan Linstedt nos anos 1990 e formalizado como Data Vault 2.0, e ele separa o modelo em três peças. Comçando por Hubs (as chaves de negócio, insert-only, só o identificador), links (os relacionamentos entre hubs, também insert-only e tratados como objetos de primeira classe) e satellites (os atributos descritivos e seu histórico, versionados via hashdiff).
A jogada genial está nos links. Num star schema, o relacionamento mora embutido na fact table: se você descobre que pedidos agora se conectam a campanhas de marketing, precisa alterar a fact e fazer backfill. No Data Vault, você só cria um novo link, link_pedido_campanha, sem tocar em nada existente. O modelo absorve mudança de fonte sem quebrar.
Qual gargalo isso minimiza? O custo organizacional da mudança e da auditoria. O cenário canônico é a empresa com 30+ sistemas de origem, três CRMs vindos de aquisições, um ERP legado, streams de evento, e um schema novo entrando a cada semana. Em Kimball puro, cada mudança dessas estoura ETL e quebra dashboard. Em setores regulados (banco, saúde), o Data Vault ainda te dá rastreabilidade total, dá pra provar de onde veio cada dado, quando, e de qual fonte.
O custo do Data Vault é ele mesmo. Se você tem cinco tabelas de origem e uma ferramenta de BI, Data Vault só adiciona complexidade sem benefício proporcional. E ninguém consome Data Vault direto, ele quase sempre alimenta uma camada de apresentação Kimball ou OBT por cima. É infraestrutura de back-office da modelagem, não a vitrine.
-- Hub, só a chave de negócio (insert-only)
CREATE TABLE hub_cliente (
  hk_cliente    BINARY(16) PRIMARY KEY,  -- hash da business key
  cliente_bk    VARCHAR(50),             -- chave natural da origem
  load_date     TIMESTAMP,
  record_source VARCHAR(50)
);
-- Link, o relacionamento como objeto de primeira classe (insert-only)
CREATE TABLE link_pedido_cliente (
  hk_link       BINARY(16) PRIMARY KEY,
  hk_cliente    BINARY(16) REFERENCES hub_cliente(hk_cliente),
  hk_pedido     BINARY(16),
  load_date     TIMESTAMP,
  record_source VARCHAR(50)
);
-- Satellite, atributos + histórico, versionado por hashdiff
CREATE TABLE sat_cliente (
  hk_cliente    BINARY(16),
  load_date     TIMESTAMP,
  hashdiff      BINARY(16),   -- muda quando qualquer atributo muda
  nome          VARCHAR(120),
  cidade        VARCHAR(80),
  PRIMARY KEY (hk_cliente, load_date)
);
Descobriu que pedido agora se liga a campanha? Cria link_pedido_campanha e segue a vida. Nenhuma tabela existente é tocada.
Anchor modeling, o primo sueco que leva a normalização ao extremo
Se o Data Vault é normalizado, o anchor modeling é normalização levada até o limite. Criado na Suécia por Olle Regardt e Lars Rönnbäck (implementações desde ~2004, paper no ER’09), ele modela tudo em sexta forma normal com quatro construtos: anchors (a identidade da entidade, uma tabela com basicamente uma coluna), attributes (cada atributo descritivo em sua própria tabela, historizada se precisar), ties (os relacionamentos) e knots (valores compartilhados e estáveis, tipo estado civil ou gênero).
O princípio que vende o anchor é: “Uma mudança grande do lado de fora vira uma mudança pequena do lado de dentro.” Como cada atributo é uma tabela isolada, adicionar um campo novo nunca exige ALTER numa entidade gigante nem backfill, você só cria mais uma tabelinha. E como tudo é historizado por design, ele lida com tempo (valid time, transaction time) nativamente.
-- Anchor, só a identidade da entidade
CREATE TABLE CU_Cliente ( CU_ID INT PRIMARY KEY );
-- Attribute historizado, o nome, numa tabela só pra ele
CREATE TABLE CU_NOM_Cliente_Nome (
  CU_ID     INT REFERENCES CU_Cliente(CU_ID),
  Nome      VARCHAR(120),
  ValidFrom DATE,
  PRIMARY KEY (CU_ID, ValidFrom)
);
-- Knot, valor compartilhado e estável
CREATE TABLE EST_EstadoCivil ( EST_ID INT PRIMARY KEY, EST_Valor VARCHAR(20) );
Qual gargalo o anchor minimiza? O mesmo do Data Vault, mudança estrutural barata e historização total, só que ainda mais radical. O custo também é maior, ler qualquer coisa exige juntar dezenas de tabelinhas (mitigado por table elimination de otimizadores que descartam joins desnecessários). É lindo academicamente, raríssimo de ver fora de nichos (seguros, varejo nórdico), e quase nunca é a camada que o usuário final toca. Vale conhecer pra entender até onde o extremo “normalizado” vai, e por que quase ninguém mora lá.
Star schema e Kimball, o compromisso da era do disco caro
Aqui mora o coração da briga. Ralph Kimball propôs a modelagem dimensional, você separa o mundo em fact tables (as métricas, os eventos mensuráveis, uma venda, um clique, um pagamento) e dimension tables (o contexto descritivo, o cliente, o produto, a data, a loja). Liga tudo por chaves e desenha uma estrela, a fact no centro, as dimensões em volta.
A abordagem é bottom-up, você entrega o data mart de uma área primeiro e vai costurando os marts via conformed dimensions (dimensões compartilhadas e consistentes entre áreas) e a bus matrix. Resolve coisas que importam de verdade:,Slowly Changing Dimensions (como rastrear que o cliente mudou de cidade sem perder o histórico), consistência de definição entre times, e uma estrutura que espelha como o negócio pensa.
Agora a parte que quase ninguém fala. Por que star schema desnormaliza as dimensões mas não chega no OBT? Porque foi desenhado pra otimizar a camada lógica de um banco row-store quando storage era caro e escasso. Você queria reduzir joins (por isso desnormaliza dentro da dimensão) mas não podia se dar ao luxo de repetir o nome do cliente em um bilhão de linhas de fato (por isso mantém a dimensão separada). Star schema é literalmente o ponto de equilíbrio entre “joins doem” e “redundância é cara”, calibrado pro hardware de 1996.
-- Dimensão, desnormalizada dentro de si, com surrogate key
CREATE TABLE dim_cliente (
  sk_cliente INT PRIMARY KEY,   -- surrogate key (interna do DW)
  cliente_bk VARCHAR(50),      -- chave natural, vinda da regra de negócio
  nome       VARCHAR(120),
  cidade     VARCHAR(80),
  uf         CHAR(2)
);
-- Fato, métricas + chaves pras dimensões (a estrela)
CREATE TABLE fact_pedido (
  sk_cliente INT REFERENCES dim_cliente(sk_cliente),
  sk_data    INT,
  valor      NUMERIC(12,2),
  qtd_itens  INT
);
-- "faturamento por UF", um join só, contra a dimensão pequena
SELECT d.uf, SUM(f.valor)
FROM fact_pedido f JOIN dim_cliente d ON d.sk_cliente = f.sk_cliente
GROUP BY d.uf;
Slowly Changing Dimensions, o problema que o star resolve e o OBT esquece
Vale um parêntese aqui, porque é onde o star schema ganha o pão e onde quase todo OBT tropeça. O cliente mudou de cidade. O que você faz com o histórico? As Slowly Changing Dimensions (SCD), do vocabulário do Kimball, são as estratégias pra isso:
- Tipo 0: nunca muda. Data de nascimento, data de cadastro. Congelado.
- Tipo 1: sobrescreve. Você atualiza a cidade e perde o passado. Simples e amnésico.
- Tipo 2: versiona. Fecha a linha antiga, abre uma nova com valid_from/valid_to e uma flag de atual. O histórico fica intacto, e o fato antigo continua apontando pra versão certa do cliente. É o cavalo de batalha.
- Tipo 3: guarda só o valor anterior numa coluna extra (cidade_anterior). Histórico raso, de um passo.
- Tipo 4: joga os atributos que mudam rápido pra uma mini-dimensão separada, pra não inchar a principal.
- Tipo 6: híbrido de 1+2+3 (o nome vem de 1+2+3 = 6), combina sobrescrita, versão e coluna anterior.
-- dim_cliente com SCD Tipo 2, cada mudança vira nova linha versionada
CREATE TABLE dim_cliente (
  sk_cliente INT PRIMARY KEY,  -- muda a cada versão
  cliente_bk VARCHAR(50),      -- chave natural, estável entre versões
  nome       VARCHAR(120),
  cidade     VARCHAR(80),
  valid_from DATE,
  valid_to   DATE,
  is_current BOOLEAN
);
Por que isso importa pro debate Kimball vs OBT? Porque um OBT que materializa “o estado atual” e sobrescreve está fazendo SCD Tipo 1 sem perceber, jogando histórico fora. Dá pra fazer SCD num OBT (carimbando versão em cada linha), mas é uma decisão que você precisa tomar de propósito. O star schema te força a encarar a pergunta “o que faço quando muda?” na hora de modelar. O OBT deixa você adiar até o dia em que alguém pergunta “qual era a cidade do cliente na data da compra?” e o dado não existe mais.
Snowflake schema, a dimensão normalizada (e a colisão de nome)
Variação do star, você normaliza as próprias dimensões, quebrando, por exemplo, uma dimensão de produto em produto → subcategoria → categoria → departamento. Vira um floco de neve. Reduz mais redundância à custa de mais joins. Pequena ironia, o snowflake schema é o oposto filosófico do que o warehouse Snowflake incentiva, que é justamente desnormalizar pesado e deixar o colunar resolver. Dois “snowflakes” puxando pra lados contrários no mesmo diagrama de arquitetura.
One Big Table, a era do colunar barato
O ponto mais à direita. Uma tabela larga, desnormalizada, com tudo pré-juntado. Zero join no momento da query, o engine escaneia e agrega. É a modelagem que parecia heresia em 2008 e virou default na stack moderna.
-- One Big Table, tudo pré-juntado uma vez, zero join na hora de consultar
CREATE TABLE obt_pedidos AS
SELECT p.pedido_id, p.data, p.valor,
       c.cliente_id, c.nome AS cliente_nome,
       ci.nome AS cidade, ci.uf
FROM pedido p
JOIN cliente c ON c.cliente_id = p.cliente_id
JOIN cidade  ci ON ci.cidade_id = c.cidade_id;

-- "faturamento por UF" agora não tem join nenhum
SELECT uf, SUM(valor) FROM obt_pedidos GROUP BY uf;
Por que o OBT voltou, o gargalo mudou de “storage” pra “shuffle”
Volta no número da Fivetran, 25% a 50% mais rápido em Redshift, Snowflake e BigQuery. Não é mágica, é física do hardware atual.
1ª Observação, em ambiente distribuído, o join é a operação cara, não o scan. Num warehouse colunar e MPP (massively parallel processing), os dados estão espalhados por vários nós. Pra fazer um join, o engine frequentemente precisa de um shuffle, mover dados pela rede entre nós pra alinhar as chaves antes de juntar. Isso é caríssimo. O OBT elimina a fase de join inteira, porque tudo já está na mesma linha. Você trocou o gargalo, saiu do CPU/rede (join/shuffle) e foi pro storage/disco (a tabela é maior). E storage hoje é barato. COmputação é o que você paga caro.
2ª Observação, a crítica óbvia ao OBT já tem resposta técnica. “Mas guardar o nome ‘Fulaninho da Silva e Silva Junior Neto’ repetido um milhão de vezes é um absurdo de espaço!” Seria, num row-store. Em colunar, não. Os engines usam Run-Length Encoding e dictionary encoding, se o valor “Fulaninho da Silva e Silva Junior Neto” aparece 1.000 vezes em sequência numa coluna, o storage não guarda a string 1.000 vezes, ele guarda o valor e a contagem. Colunar agrupa dados do mesmo tipo, o que dá taxas de compressão absurdamente melhores que row-based, e ainda lê só as colunas que a query pediu. A redundância que arrepiava o DBA de 2008 é quase de graça hoje. O que custa num warehouse colunar não é o byte armazenado, é o padrão de acesso.
3ª Observação, mas star schema não morreu, ele ganha em outro eixo. OBT ganha em velocidade de leitura pura. Star schema ganha em governança e histórico, conformed dimensions garantem que “cliente ativo” significa a mesma coisa em todo lugar, e Slowly Changing Dimensions rastreiam mudança ao longo do tempo de um jeito que o OBT, sozinho, não faz. Você não escolhe o vencedor olhando o benchmark de query. Você escolhe olhando se o seu problema é latência de dashboard ou consistência de definição entre analistas e áreas.
Activity schema, a via que não cabe no eixo
Tem uma abordagem moderna que recusa o eixo inteiro. O activity schema, criado por Ahmed Elsamadisi (fundador da Narrator, apresentado no Coalesce 2021), propõe modelar tudo numa única tabela time-series de 11 colunas, sem fact, sem dimensão, sem JSON. Em vez de “fatos e dimensões”, o dado vira “um cliente fez uma atividade num instante”. Cada linha é uma atividade: fez pedido, visitou o site, abriu ticket, cancelou.
-- Activity Stream: uma linha por "entidade fez atividade X no tempo T"
CREATE TABLE activity_stream (
  activity_id          VARCHAR,    -- id da ocorrência
  ts                   TIMESTAMP,  -- quando
  customer             VARCHAR,    -- quem (a entidade)
  activity             VARCHAR,    -- o quê: 'fez_pedido', 'visitou_site'...
  anonymous_customer_id VARCHAR,
  feature_1            VARCHAR,    -- contexto flexível por atividade
  feature_2            VARCHAR,
  feature_3            VARCHAR,
  revenue_impact       NUMERIC,
  link                 VARCHAR,
  activity_occurrence  INT,        -- 1ª, 2ª, 3ª vez que a entidade fez isso
  activity_repeated_at TIMESTAMP
);
A promessa é gigante (e o próprio autor admite que soa como papo furado), qualquer pergunta de negócio sai dessa tabela só, com uma camada de modelagem única cuja única dependência é o dado cru. “Faturamento por mês” e “tempo médio até a segunda compra” vêm da mesma estrutura, sem montar um modelo dimensional novo pra cada pergunta. Onde isso brilha é em análise comportamental e de jornada, exatamente o tipo de pergunta temporal (“o que o usuário fez entre A e B”) que dá nó num star schema. O custo é que casos clássicos de dimensão (juntar um atributo que muda no tempo) viram trabalho de borda, resolvido com joins especiais tipo last-before. É uma filosofia inteira, não um ponto no espectro de normalização, e por isso merece estar no mapa mesmo sem caber na régua.
O eixo da camada, refinamento, não forma
Agora o eixo ortogonal. Aqui não se discute o quanto normalizar, se discute o quão pronto o dado está pra consumo.
Medallion: bronze, silver, gold
A Databricks popularizou o termo por volta de 2019–2020 junto com o lakehouse, mas o conceito é antigo e, importante, é um padrão lógico, não um produto. Você implementa medallion em Snowflake, BigQuery, Fabric, no que for.
- Bronze, ingestão e preservação. O dado cru, o mais próximo possível da fonte, transformação mínima. Captura confiável, nada de regra de negócio aqui.
- **Silver,**limpeza e padronização. Onde o dado vira utilizável: dedupe, cast, validação, quarentena de registro corrompido, joins que conformam entidades.
- Gold, serviço. Agregado, curado, pronto pra decisão. É aqui que você aplica Kimball ou OBT. O gold é a forma; o medallion é o caminho até ele.
O acesso costuma espelhar a confiança: bronze restrito a engenharia de dados, silver pros cientistas e power users, gold liberado pra organização ampla.
4ª Observação, os modos de falha do medallion são quase sempre de disciplina, não de tecnologia. Os clássicos que aparecem em todo post-mortem de engenharia:
- Regra de negócio vazando pro bronze (que deveria ser cru).
- Silver virando um “segundo bronze”, um depósito sem governança.
- Gold reconstruído do zero por cada time, sem reuso, multiplicando definições divergentes.
Medallion não é sobre as três pastas terem os nomes certos. É sobre cada camada ter um contrato e uma fronteira de responsabilidade clara. Pasta com nome bonito e lógica bagunçada é só um lake virando swamp com etapas extras.
dbt: staging, intermediate, marts
É a versão operacional do mesmo eixo, no mundo da analytics engineering.
- Staging, um modelo por tabela de origem, geralmente materializado como view. Convenção stg_
__ . Aqui você renomeia coluna, faz cast, padroniza, e só isso. Regra de ouro: nada de join entre domínios, nada de agregação. Por quê? Pra preservar o grão da origem. Se você agrega cedo, trava o grão e mata o reuso a jusante. - Intermediate, int_, onde a complexidade é absorvida. Joins, lógica de negócio empilhada em camadas. Uma regra de ouro de DAG, vários inputs entrando num modelo intermediate é ótimo e esperado, várias setas saindo dele é red flag.
- Marts, a entrega. fact_/dim_ em estilo Kimball, ou marts por domínio (mart_vendas, mart_churn). Materializado como tabela, por performance. Cada mart representa uma entidade num grão único.
Repara que staging→intermediate→marts é exatamente bronze→silver→gold com outro vocabulário e mais opinião sobre SQL. E que, de novo, o mart é onde a forma é decidida. Camada e forma se encontram no produto final.
O intruso: tidy data não é nem star nem OBT
Aqui entra o conceito que ciêntista de dados (alo comunidade do tidyverse) venera e que a turma de engenharia de dados às vezes nem conhece pelo nome.
Hadley Wickham publicou Tidy Data em 2014 no Journal of Statistical Software, e definiu três regras pro dado “arrumado”, cada variável é uma coluna, cada observação é uma linha, cada tipo de unidade observacional é uma tabela. O mantra que rodou o mundo do R e depois influenciou o pandas. É o “normal form” do analista, e ele otimiza um gargalo bem específico, a facilidade de manipular, modelar e visualizar com ferramentas vetorizadas. Ferramenta tidy entra dado tidy e sai dado tidy, e aí um conjunto pequeno de operações (melt, split, cast) cobre quase qualquer bagunça.
E aqui está a tensão que quase ninguém explicita, tidy data é formato longo e estreito, quase o oposto do OBT, que é largo. As duas tribos chamam coisas opostas de “boa modelagem”.
Pega o exemplo clássico do próprio Wickham, temperatura medida em três cidades por semana. O instinto de planilha é fazer uma coluna por cidade (largo). A versão tidy é três colunas: semana, cidade, temperatura (longo). Pra um ggplot ou um seaborn, a versão longa é trivial de plotar. Pra um dashboard de BI que lista cidades lado a lado, a versão larga é o que você quer.
A resolução não é “um está certo”. É que eles servem camadas e propósitos diferentes, tidy/longo é a forma de consumo pra análise estatística e visualização, wide/OBT é a forma de serviço pra BI. Um cientista de dados puxa o gold, faz um melt pra ficar tidy no notebook, roda o modelo. Não há contradição, há tradução entre fronteiras. O erro é tentar impor o normal form de uma tribo na camada da outra.
O semantic layer muda a resposta de novo
Quando você acha que fechou o caso “OBT pra leitura, star pra governança”, aparece uma camada nova que reembaralha tudo, o semantic layer (ou metrics layer).
A própria documentação do dbt é explícita sobre isso. Sem semantic layer, a recomendação é desnormalizar pesado nos marts. Mas se você usa o Semantic Layer com o MetricFlow, a recomendação inverte, ficar o mais normalizado possível, pra dar ao motor de métricas o máximo de flexibilidade pra montar os joins na hora.
Por que isso acontece? Porque o semantic layer move a decisão de forma pra runtime. Você define a métrica e as entidades uma vez, de forma normalizada e canônica, e o OBT que o BI consome passa a ser gerado sob demanda pela query. Star schema deixa de ser a vitrine e vira o input da camada semântica. A desnormalização não desaparece, ela só deixa de ser uma decisão de modelagem física e vira uma decisão de compilação de query.
A lição meta aqui, que vale pro artigo inteiro, toda vez que uma ferramenta nova muda a economia, a “melhor prática” de modelagem muda junto. Colunar reabriu o OBT. Semantic layer reabriu a normalização. Quem trata modelagem como dogma fica sempre uma geração de hardware atrás.
Data mart e data mesh: a forma encontra a organização
Até aqui falei de forma e de camada. Falta o eixo da escopo organizacional, que é onde data mart e data mesh entram, e onde a discussão deixa de ser técnica e vira sociotécnica.
Data mart, o cômodo mobiliado
Um data mart é um recorte do warehouse focado num domínio ou departamento: marketing, finanças, logística. Se o warehouse é a casa, o mart é o cômodo já mobiliado pra um time específico morar. Na tradição Kimball (bottom-up), você constrói os marts primeiro e os integra via conformed dimensions. Na tradição Inmon (top-down), o EDW corporativo vem primeiro e os marts são derivados dele. A briga Kimball vs Inmon, no fundo, sempre foi sobre ordem de construção e propriedade, não sobre forma de tabela. Quem entrega valor primeiro, a área ou o corporativo?
Data mesh, o mart promovido a princípio organizacional
Em 2019, Zhamak Dehghani, então na ThoughtWorks, cunhou o data mesh e levou essa pergunta de propriedade ao extremo lógico. A tese, o time de dados central vira gargalo porque não tem contexto de domínio, então constrói a coisa errada, e os domínios esperam meses por dado. A solução é descentralizar, com quatro princípios:
- Domain-oriented ownership, quem gera e entende o dado é dono dele. Marketing é dono do dado de marketing. Baseado no domain-driven design do Eric Evans.
- Data as a product, o dado de cada domínio é tratado como produto, com o consumidor como cliente, com SLA, documentação, descobribilidade. Esse é o pulo conceitual.
- Self-serve data platform, uma plataforma que reduz a carga cognitiva pros domínios produzirem e consumirem dado sem reinventar infra.
- Federated computational governance, padrões globais (interoperabilidade, segurança, contratos) aplicados de forma federada e automatizada, não por um comitê manual.
Data mesh não é uma forma de tabela, é um modelo operacional. Mas ele depende das decisões de forma e camada que vimos, cada data product de domínio ainda precisa ser modelado (star, OBT, o que servir), ainda passa por refinamento (medallion/dbt), e ainda precisa de um contrato semântico pra ser interoperável. O mesh não substitui modelagem, ele distribui a responsabilidade dela.
Vale o aviso, mesh é uma mudança organizacional antes de ser técnica. Quem trata como projeto só de tecnologia falha. E muito time pequeno que adotou “mesh” só recriou silos com nome bonito. Mesh resolve problema de escala organizacional. Se você tem um time de dados e cinco fontes, mesh é overhead, do mesmo jeito que Data Vault é.
Dado não é fim: modelagem é a interface que destrava todo mundo
Toda essa discussão de 3NF, Kimball, OBT, medallion não é sobre elegância de diagrama. É sobre quem consegue fazer pergunta ao dado sem abrir um ticket.
Pensa no que acontece quando a modelagem é ruim. Cada pergunta de negócio (“qual a retenção de quem entrou pela campanha X?”) vira um pedido pra engenharia de dados. A engenharia entra numa fila. O analista espera três dias, recebe um número, descobre que era a métrica errada, refaz o pedido. O cientista de dados não confia em nenhuma tabela e refaz o pipeline inteiro no notebook dele, criando a 14ª definição de “usuário ativo” da empresa. O dado virou um fim em si mesmo, um ativo que a empresa coleta, armazena, e do qual extrai uma fração ridícula do valor, porque o gargalo humano é o time de dados.
Agora pensa no oposto. Quando a modelagem é boa, ela é a API. O grão bem definido, os nomes consistentes, as conformed dimensions, o semantic layer com as métricas canônicas, tudo isso é o contrato que deixa o analista, o cientista e o pessoal de negócio explorarem sozinhos. O grão de uma stg_orders preservado é o que permite que três perguntas diferentes sejam respondidas sem reescrever nada. A camada gold liberada com governança é o que tira a engenharia do meio do caminho. O “data as a product” do mesh é literalmente isso: o dado tratado como produto que se autodocumenta e se autoatende.
É essa a leitura que sustenta o artigo inteiro. A modelagem física boa é o que deixa o banco escalar sem trair em produção. A modelagem da métrica boa é o que deixa o experimento ser confiável e rápido. A modelagem analítica boa é o que deixa a empresa inteira fazer pergunta. O fio comum é sempre o mesmo, modelagem boa é a que some da frente das pessoas.
Esse é o critério final, e ele é melhor que qualquer benchmark. Não pergunte “essa modelagem é Kimball ou OBT?”. Pergunte “depois dessa modelagem, quantas pessoas a mais conseguem responder a própria pergunta sem me pedir licença?”. Se a resposta é “mais”, você acertou, independente do nome no diagrama.
Recomendações da minha cabeça
O que eu de fato levo desse estudo, em ordem de importância.
- Escolha o ponto do eixo pelo gargalo. Storage barato e leitura dominante? OBT no gold resolve e ganha de star schema no benchmark. Governança, histórico e consistência entre muitos times? Star schema com conformed dimensions e SCD. Trinta fontes mudando todo trimestre e auditoria regulatória? Data Vault no raw, Kimball ou OBT na apresentação. Cinco fontes e um BI? Star schema simples.
- Não confunda forma com camada. “Usamos medallion” e “usamos Kimball” não competem, se compõem. A forma é decidida no gold/mart. Bronze/silver/gold é o caminho até lá. Quem diz que substituiu um pelo outro está medindo quilômetro em quilo.
- Star schema na entrada do semantic layer, OBT no gold de consumo direto. Se você tem metrics layer, mantenha normalizado e deixe a camada gerar o wide na query. Se não tem, desnormalize pesado no mart. A ferramenta define a resposta, não o dogma.
- Tidy no notebook, wide no dashboard. Não imponha o formato longo do cientista de dados na camada de BI, nem o OBT largo dentro do pipeline de modelagem estatística. Traduza nas fronteiras, é barato.
- Data Vault, anchor e data mesh só quando você tem o problema deles. Os três são respostas a problemas de escala (de fontes, de mudança estrutural, de organização). Anchor leva isso ao 6NF e raramente sai de nichos. Aplicados em ambiente pequeno, viram overhead puro que apodrece rapidamente. O custo de adoção é real e cobrado todo dia.
- Meça antes de denormalizar. Antes de jogar tudo num OBT, olhe o padrão de query real (qual join dói, qual coluna é filtrada, qual é o volume). Denormalização especulativa é otimização no escuro, parece ganho, costuma ser fragmentação e custo de manutenção.
- Trate modelagem como produto, não como diagrama. O sucesso da sua modelagem se mede em pessoas destravadas, não em terceira forma normal alcançada. Documente o grão, exponha a definição de métrica, dê acesso governado ao gold. A modelagem é a interface de autoatendimento da empresa com o próprio dado.
- Se a sua pergunta é comportamental, considere o activity schema antes de torturar um star. “O que o usuário fez entre o cadastro e a primeira compra”, “quanto tempo até repetir”, funil e jornada são perguntas temporais que dão nó em fact/dimensão e saem natural de uma activity stream. Não precisa adotar a stack inteira da Narrator pra roubar a ideia do modelo de eventos.
Conclusão
Anchor, 3NF, Data Vault, star schema, snowflake schema e OBT são o mesmo eixo, normalização contra desnormalização, e cada um é um ponto calibrado pra um gargalo de uma época. Star schema é a resposta certa pra uma pergunta de economia de 1996, e o colunar mudou a pergunta. O activity schema nem entra no eixo, ele recusa fact/dimensão e modela o mundo como uma sequência de eventos. Bronze/silver/gold e staging/intermediate/marts são outro eixo, o de refinamento, e se compõem com o primeiro em vez de competir. Tidy data é o normal form do analista, longo onde o OBT é largo, e a tensão entre eles some quando você entende que servem camadas diferentes. Data mart e data mesh sobem a discussão pro plano organizacional, onde a pergunta vira de quem é a propriedade do dado e como faz a gestão da governança.
O ponto que atravessa tudo isso é que infraestrutura de dados raramente tem resposta absoluta, tem resposta condicional ao seu gargalo e à economia da sua stack. Modelagem não é estética, é economia, ergonomia e menor carga cognitiva, e no fim é a pergunta de quem você está tentando destravar. Tratada como dogma, ela fica sempre uma geração de hardware atrás.
A pergunta certa nunca foi “Kimball ou OBT”. Foi “onde está meu gargalo, e quem precisa explorar esse dado sem me pedir licença”.
Modelo de dados bom não é o mais bonito no diagrama. É o que some da frente das pessoas e deixa elas perguntarem.
Referências
- Wickham, H. (2014). “Tidy Data”. Journal of Statistical Software, 59(10). https://www.jstatsoft.org/v59/i10/
- Kimball, R., Ross, M. (2013). The Data Warehouse Toolkit: The Definitive Guide to Dimensional Modeling. 3ª ed. Wiley.
- Inmon, W. H. Building the Data Warehouse / Corporate Information Factory (CIF).
- Linstedt, D., Olschimke, M. (2015). Building a Scalable Data Warehouse with Data Vault 2.0. Morgan Kaufmann.
- Dehghani, Z. (2022). Data Mesh: Delivering Data-Driven Value at Scale. O’Reilly. (Conceito cunhado em 2019, ThoughtWorks; quatro princípios: domain ownership, data as a product, self-serve data platform, federated computational governance.)
- Fivetran. “Star Schema vs. OBT for Data Warehouse Performance”. https://www.fivetran.com/blog/star-schema-vs-obt
- Databricks. “What is the medallion lakehouse architecture?”. https://docs.databricks.com/aws/en/lakehouse/medallion
- dbt Labs. “How we structure our dbt projects” e “Marts: Business-defined entities”. https://docs.getdbt.com/best-practices/how-we-structure/1-guide-overview
- Regardt, O., Rönnbäck, L., Bergholtz, M., Johannesson, P., Wohed, P. (2009). “Anchor Modeling — An Agile Modeling Technique Using the Sixth Normal Form for Structurally and Temporally Evolving Data”. ER’09. https://www.anchormodeling.com
- Elsamadisi, A. (2021). “Introducing the activity schema: data modeling with a single table”. Coalesce / dbt. https://www.activityschema.com